



zplCloud Blog
zplCloud CLI でローカルの MongoDB をラベルのデータソースとして接続する
フィルターはネイティブのクエリドキュメントになり、ネットワーク内のエージェントが実行します。接続文字列は手元のマシンに残ります。
エクスポートも、コレクションのクラウド上のコピーも不要
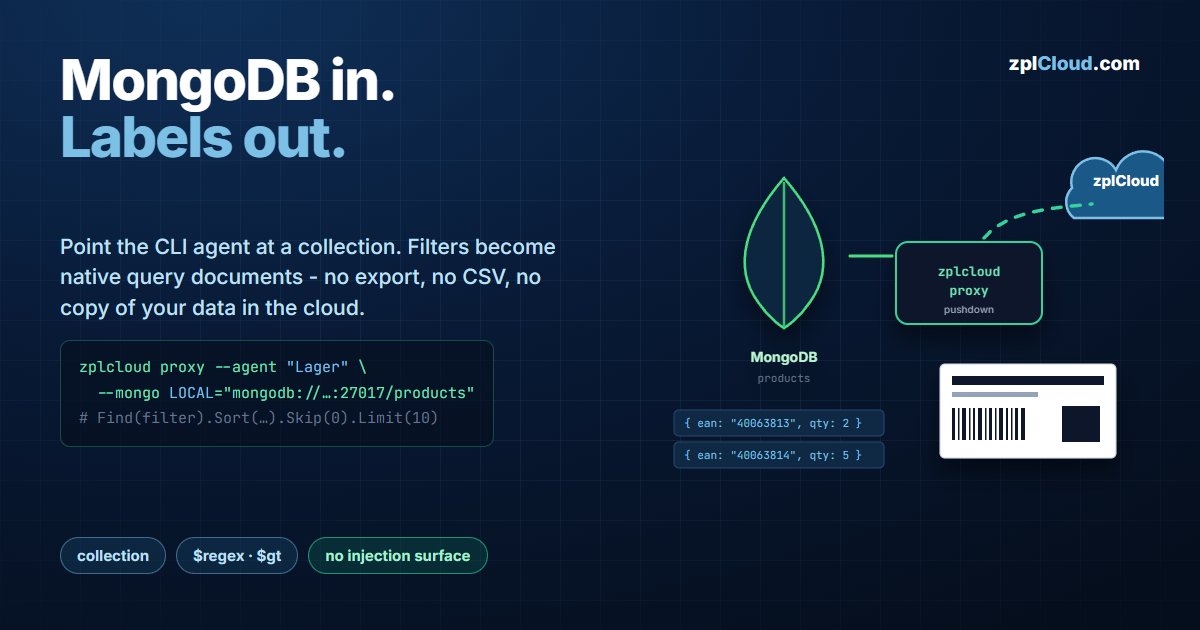
商品データ、受注明細、シリアル番号。すでに MongoDB にあるのなら、ラベルを印刷するために CSV へ書き出すのは純然たる無駄であり、しかもそのエクスポートは書き出した瞬間から古くなります。
zplCloud のデータハブはコレクションに直接つなぎます。ネットワーク内の CLI エージェントが接続文字列を保持し、プラットフォームはクエリを記述し、エージェントは条件に合うドキュメントだけを返します。データベースはインターネットから到達できないままです。
アーキテクチャ
zplcloud proxy は api.zplcloud.com への送信方向の TLS 接続を 1 本維持します。こちら側は何も待ち受けないため、受信ポートもファイアウォールの例外も不要です。クエリ、ソート、ページングはプッシュダウンされます。エージェントは本物の MongoDB クエリを組み立て、Find(filter).Sort(…).Skip(n).Limit(m) を呼び出します。コレクションがダウンロードされることはありません。
Step 1 - 自分の MongoDB を指定してエージェントを起動する
# Multiple --mongo flags are allowed; the NAME is what you pick in the platform.
zplcloud proxy --agent "Lager" \
  --mongo LOCAL="mongodb://admin:…@127.0.0.1:27017/products" \
  --mongo PROD="mongodb://admin:…@mongo.internal.lan:27017/erp"
接続文字列にはデータベース名を含める必要があります。ホストの後ろの部分、…:27017/products です。これがないと、エージェントにはサーバーだけがあって、照会するデータベースがありません。
秘密情報はシェルの履歴に残さないほうが安全です。
$env:ZPLCLOUD_MONGO_LOCAL_CONNECTION = "mongodb://admin:…@127.0.0.1:27017/products"
zplcloud proxy --agent "Lager"
バナーが登録された内容を教えてくれます。MongoDB servers: LOCAL, PROD のように表示されます。プラットフォームに対する認証は --api-key <key> または ZPLCLOUD_API_KEY で行い、--service-install(Linux/Raspberry Pi では systemd、Windows ではタスクスケジューラ)または docker-compose.agent.yml の ZPLCLOUD_MONGO_LOCAL_CONNECTION で常駐化します。
エージェントには、必要なデータベースだけに絞った読み取り専用ユーザーを割り当ててください。エージェントはそのユーザーとして実行するため、MongoDB 自身のロールモデルが権限の境界になります。
Step 2 - データソースを作成する
データソースでは、エージェントが Remote SQL Server の下に表示され、MongoDB インスタンスごとにチップが並びます。クリックするとフォームがあらかじめ入力されます。
| 項目 | 値 |
|---|---|
| 名前 | Lager-Artikel |
| 種別 | MongoDB |
| サーバー | LOCAL(--mongo LOCAL=… で付けた名前) |
| コレクション | products |
テスト はインスタンスに ping を送り、server · database を返します。項目はドキュメントをサンプリングし、フィールド名を BSON の型とともに一覧表示します。
フィールドの検出はサンプルに基づきます。これはスキーマレスなストアでは重要です。最初のドキュメントには無く、後のドキュメントにはあるフィールドは、一覧に現れません。存在が分かっているなら、バインディングで手動で追加してください。
Step 3 - フィルターがどう実行されるか
クエリで組み立てるフィルター行、つまり列、演算子、値は、MongoDB のフィルタードキュメントに変換され、エージェントが実行します。
| UI の演算子 | MongoDB |
|---|---|
含む | { ean: { $regex: "40063813" } } |
で始まる | { ean: { $regex: "^40063813" } } |
= | { ean: "40063813" } |
> / < | { price: { $gt: 10 } } / { $lt: … } |
はっきり書いておくべき帰結が 2 つあります。
- インジェクションの入り込む余地はありません。 MongoDB のフィルターは BSON ドキュメント、つまりデータであって、コードとして解析される文字列ではありません。
$や{}を含む値も、やはり単なる値です。 - アンカーのない
$regexはインデックスを使えません。 大きなコレクションでの含むは全件走査になります。で始まるは^…を生成するので、そのフィールドの通常のインデックスで処理できます。大規模なコレクションではこちらを選んでください。
厳格な上限(エージェントのソースより)
| 上限 | 値 |
|---|---|
| 1 リクエストあたりの行数 | 1000。limit は切り詰められ、既定は 100 です |
| サーバー選択のタイムアウト | 15 秒。到達できないレプリカセットは数分後ではなくここで失敗します |
| 実行される操作 | 読み取りのみ。ソート、スキップ、リミット付きの Find |
これより大きい結果はページングされます。プラットフォームは Skip を増やしながらページを次々に要求し、各ページは 1000 ドキュメントが上限です。そのため 10 000 枚のラベルをバッチ印刷しても、どちら側でも同時にメモリに載るのは 1 ページ分だけです。
なお、大きなオフセットでの Skip は、MongoDB が読み飛ばすドキュメントをたどることを意味します。数十万件規模のカタログでは、インデックスの付いたソートフィールドがあればこれは安価に済みますが、インデックスのないソートではそうはいきません。
Step 4 - デザイナーとプリントビューで使う
- デザイナー → テストデータ タブ → データソース: データソースを選んで 読み込む を押すと、すべてのバインディングが実際のドキュメントで描画されます。文字数、欠損値、エンコーディングの問題は、ラベルロールの上ではなくここで見つかります。
- プリントビュー → 設定 → データソース(データハブ): プレビューも印刷もライブのクエリを使います。作業者に MongoDB が背後にあることは見えません。
障害のパターン
| 症状 | 原因 |
|---|---|
| エージェントは動いているのにデータハブにチップが出ない | --mongo の名前が無い、または API キーが別のワークスペースのもの |
テスト が約 15 秒後に失敗する | サーバー選択のタイムアウト。エージェントのマシンからホストに到達できない、ポートが違う、あるいはレプリカセットのメンバーがエージェントで解決できない名前を広告している |
テスト が即座に認証エラーで失敗する | ユーザー名やパスワードが違う、または認証用のデータベースがデータ用のデータベースと異なる(?authSource=admin) |
項目 にフィールドが出てこない | サンプリングしたドキュメントにそれが含まれていない。スキーマレスなコレクションには代表的なサンプルが必要です |
| 見えている値でフィルターしても何も返らない | 型の不一致。数値フィールドを文字列と比較しています。フィールド一覧で型を確認してください |
プラン
データハブ(CLI エージェント経由の MongoDB および SQL Server のデータソース)は Pro プランに含まれます。料金ページをご覧ください。