



zplCloud Blog
MongoDB como fonte de dados: sem exportação, sem cópia no cloud
Os filtros viram documentos de consulta nativos, executados pelo agente na sua rede. A string de conexão fica na sua máquina.
Sem exportação, sem cópia da sua collection no cloud
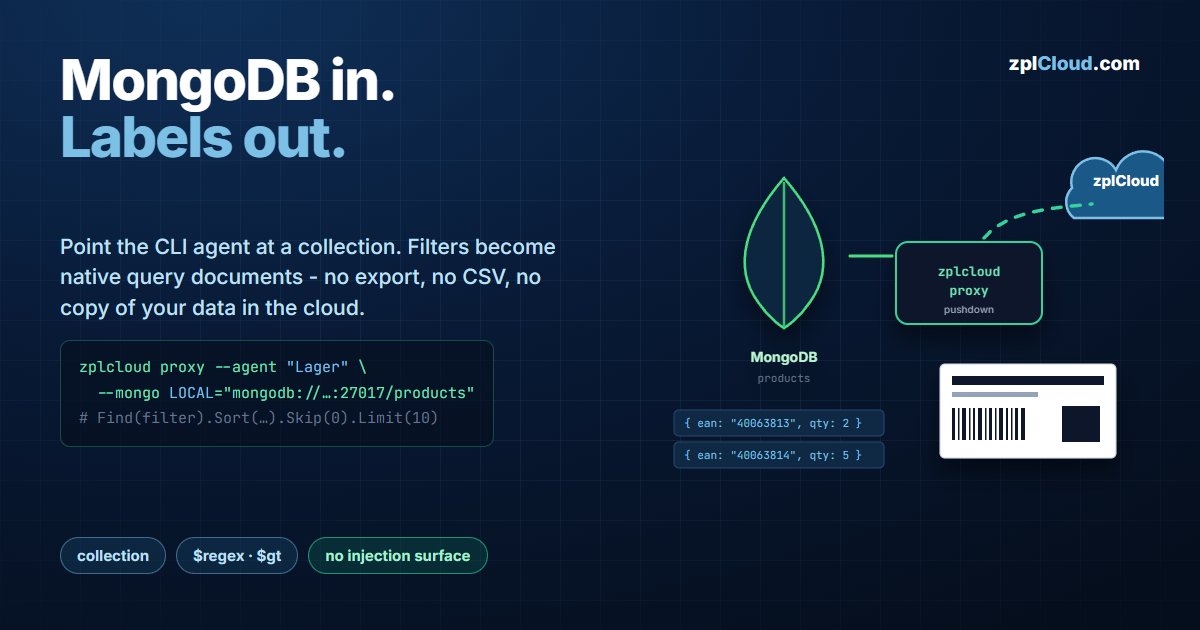
Dados de produto, itens de pedido, números de série - se já vivem no MongoDB, exportá-los para CSV para que uma etiqueta possa imprimi-los é puro overhead, e a exportação fica obsoleta no momento em que é escrita.
O data hub zplCloud conecta a collection diretamente. Um agente CLI na sua rede detém a string de conexão, a plataforma descreve a consulta, e o agente retorna apenas os documentos correspondentes. O banco de dados permanece inacessível pela internet.
Arquitetura
zplcloud proxy mantém uma conexão TLS de saída para api.zplcloud.com. Nada escuta do seu lado, então não há porta de entrada nem exceção de firewall. Consulta, ordenação e paginação são empurradas para baixo: o agente constrói uma consulta MongoDB real e chama Find(filter).Sort(…).Skip(n).Limit(m). A collection nunca é baixada.
Passo 1 - inicie o agente com seu MongoDB
# Vários flags --mongo são permitidos; o NOME é o que você escolhe na plataforma.
zplcloud proxy --agent "Lager" \
  --mongo LOCAL="mongodb://admin:…@127.0.0.1:27017/products" \
  --mongo PROD="mongodb://admin:…@mongo.internal.lan:27017/erp"
A string de conexão deve incluir o nome do banco - é a parte depois do host, …:27017/products. Sem ele, o agente tem um servidor, mas nenhum banco para consultar.
Segredos são melhor mantidos fora do histórico do shell:
$env:ZPLCLOUD_MONGO_LOCAL_CONNECTION = "mongodb://admin:…@127.0.0.1:27017/products"
zplcloud proxy --agent "Lager"
O banner confirma o que foi registrado: MongoDB servers: LOCAL, PROD. Autentique-se na plataforma com --api-key <key> ou ZPLCLOUD_API_KEY; torne permanente com --service-install (systemd no Linux/Raspberry Pi, tarefa agendada no Windows) ou com ZPLCLOUD_MONGO_LOCAL_CONNECTION no docker-compose.agent.yml.
Dê ao agente um usuário somente leitura com escopo no banco que ele precisa. O agente executa com esse usuário, então o próprio modelo de funções do MongoDB é o limite de permissões.
Passo 2 - crie a fonte de dados
Em Fontes de dados, o agente aparece sob Remote SQL Server com um chip por instância MongoDB. Clicar nele pré-preenche o formulário.
| Campo | Valor |
|---|---|
| Nome | Lager-Artikel |
| Tipo | MongoDB |
| Servidor | LOCAL (o nome de --mongo LOCAL=…) |
| Collection | products |
Testar faz ping na instância e retorna servidor · banco de dados. Campos amostra um documento e lista os nomes dos campos com seus tipos BSON.
A descoberta de campos funciona a partir de uma amostra, o que importa em um armazenamento sem esquema: se os primeiros documentos não têm um campo que documentos posteriores têm, ele não aparecerá na lista. Adicione-o manualmente no binding se souber que existe.
Passo 3 - como um filtro é executado
A linha de filtro que você constrói em Consultar - coluna, operador, valor - é traduzida em um documento de filtro MongoDB e executada pelo agente:
| Operador na UI | MongoDB |
|---|---|
contém | { ean: { $regex: "40063813" } } |
começa com | { ean: { $regex: "^40063813" } } |
= | { ean: "40063813" } |
> / < | { price: { $gt: 10 } } / { $lt: … } |
Duas consequências que valem ser ditas claramente:
- Não há superfície de injeção. Um filtro MongoDB é um documento BSON - dados, não uma string analisada como código. Um valor contendo
$ou{}é apenas um valor. $regexsem âncora não pode usar índice.contémem uma collection grande é uma varredura completa.começa comproduz^…, que um índice normal nesse campo pode atender. Em collections grandes, prefira-o.
Os limites rígidos (do código-fonte do agente)
| Limite | Valor |
|---|---|
| Linhas por solicitação | 1000 - limit é limitado, o padrão é 100 |
| Timeout de seleção de servidor | 15 s - um replica set inacessível falha aqui, não depois de minutos |
| Operação executada | somente leitura: Find com sort, skip e limit |
Conjuntos de resultados maiores são paginados: a plataforma solicita página após página com um Skip crescente, cada uma limitada a 1000 documentos. A impressão em lote de 10 000 etiquetas nunca mantém mais de uma página na memória, de nenhum lado.
Observe que Skip em um offset grande faz o MongoDB percorrer os documentos pulados. Para catálogos de centenas de milhares, um campo de ordenação indexado mantém isso barato; uma ordenação sem índice não.
Passo 4 - use no designer e nas Print Views
- Designer → aba Dados Teste → Fonte de dados: escolha a fonte de dados, pressione Carregar, e cada binding é renderizado com documentos reais. Comprimentos de campo, valores ausentes e problemas de codificação aparecem aqui em vez de no rolo de etiquetas.
- Print Views → configuração → Fonte de dados (data hub): a visualização e a impressão usam a consulta ao vivo. O operador nunca vê que há MongoDB por trás.
Modos de falha
| Sintoma | Causa |
|---|---|
| O agente roda, sem chip no data hub | nome --mongo ausente, ou a chave de API pertence a outro workspace |
Testar falha após ~15 s | timeout de seleção de servidor - host inacessível da máquina do agente, porta errada, ou um replica set cujos membros anunciam nomes que o agente não pode resolver |
Testar falha instantaneamente com erro de auth | usuário/senha errados, ou o banco de autenticação difere do banco de dados (?authSource=admin) |
Campos perde um campo | o documento amostrado não o contém - collections sem esquema precisam de uma amostra representativa |
| O filtro não retorna nada em um valor visível | incompatibilidade de tipo: um campo numérico comparado com uma string. Verifique o tipo na lista de campos |
Plano
O data hub (fontes de dados MongoDB e SQL Server através do agente CLI) faz parte do plano Pro. Veja a página de preços.