



zplCloud Blog
MongoDB डेटा स्रोत के रूप में: बिना निर्यात, क्लाउड में कोई प्रति नहीं
फ़िल्टर नेटिव क्वेरी डॉक्यूमेंट बन जाते हैं, जिन्हें आपके नेटवर्क में चलने वाला एजेंट निष्पादित करता है। कनेक्शन स्ट्रिंग आपकी मशीन पर ही रहती है।
बिना निर्यात, आपके collection की कोई प्रति क्लाउड में नहीं
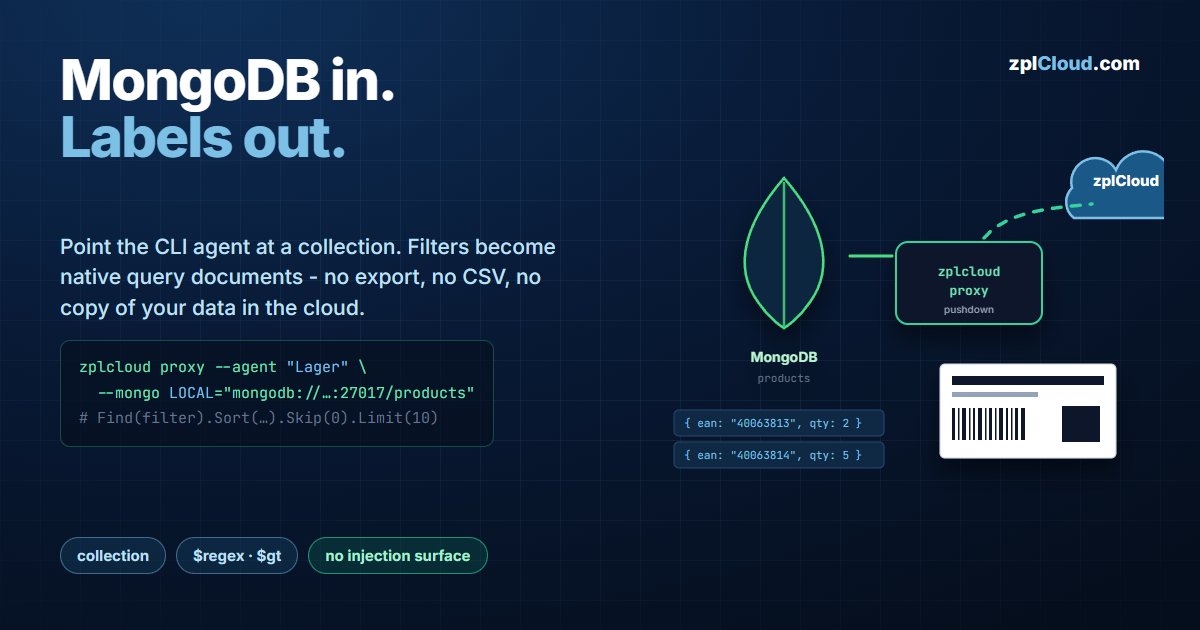
उत्पाद डेटा, ऑर्डर आइटम, सीरियल नंबर - यदि वे पहले से MongoDB में रहते हैं, तो लेबल प्रिंट करने के लिए उन्हें CSV में निर्यात करना शुद्ध ओवरहेड है, और निर्यात लिखते ही पुराना हो जाता है।
zplCloud डेटा हब collection को सीधे जोड़ता है। आपके नेटवर्क में एक CLI एजेंट कनेक्शन स्ट्रिंग रखता है, प्लेटफ़ॉर्म क्वेरी का वर्णन करता है, और एजेंट केवल मेल खाते दस्तावेज़ लौटाता है। डेटाबेस इंटरनेट से अप्राप्य रहता है।
आर्किटेक्चर
zplcloud proxy api.zplcloud.com के लिए एक आउटबाउंड TLS कनेक्शन रखता है। आपकी तरफ कुछ भी नहीं सुनता, इसलिए कोई इनबाउंड पोर्ट नहीं और कोई फ़ायरवॉल अपवाद नहीं। क्वेरी, सॉर्ट और पेजिंग नीचे धकेली जाती है: एजेंट एक वास्तविक MongoDB क्वेरी बनाता है और Find(filter).Sort(…).Skip(n).Limit(m) कॉल करता है। Collection कभी डाउनलोड नहीं होता।
चरण 1 - अपने MongoDB के साथ एजेंट शुरू करें
# कई --mongo फ्लैग की अनुमति है; NAME वही है जो आप प्लेटफ़ॉर्म में चुनते हैं।
zplcloud proxy --agent "Lager" \
  --mongo LOCAL="mongodb://admin:…@127.0.0.1:27017/products" \
  --mongo PROD="mongodb://admin:…@mongo.internal.lan:27017/erp"
कनेक्शन स्ट्रिंग में डेटाबेस नाम शामिल होना चाहिए - यह होस्ट के बाद का भाग है, …:27017/products। इसके बिना एजेंट के पास सर्वर तो है पर कोई डेटाबेस नहीं जिससे पूछा जाए।
रहस्यों को शेल इतिहास से बाहर रखना बेहतर है:
$env:ZPLCLOUD_MONGO_LOCAL_CONNECTION = "mongodb://admin:…@127.0.0.1:27017/products"
zplcloud proxy --agent "Lager"
बैनर पुष्टि करता है कि क्या पंजीकृत हुआ: MongoDB servers: LOCAL, PROD। प्लेटफ़ॉर्म पर --api-key <key> या ZPLCLOUD_API_KEY से प्रमाणित करें; --service-install (Linux/Raspberry Pi पर systemd, Windows पर शेड्यूल किया गया कार्य) या docker-compose.agent.yml में ZPLCLOUD_MONGO_LOCAL_CONNECTION से स्थायी बनाएँ।
एजेंट को उस डेटाबेस तक सीमित केवल-पढ़ने वाला उपयोगकर्ता दें जिसकी उसे आवश्यकता है। एजेंट उस उपयोगकर्ता के साथ निष्पादित होता है, इसलिए MongoDB का अपना भूमिका मॉडल ही अनुमति सीमा है।
चरण 2 - डेटासोर्स बनाएँ
डेटा स्रोत में एजेंट Remote SQL Server के अंतर्गत प्रति MongoDB इंस्टेंस एक चिप के साथ दिखाई देता है। उस पर क्लिक करने से फ़ॉर्म पहले से भर जाता है।
| फ़ील्ड | मान |
|---|---|
| नाम | Lager-Artikel |
| प्रकार | MongoDB |
| सर्वर | LOCAL (--mongo LOCAL=… से नाम) |
| Collection | products |
परीक्षण इंस्टेंस को पिंग करता है और सर्वर · डेटाबेस लौटाता है। फ़ील्ड एक दस्तावेज़ का नमूना लेता है और फ़ील्ड नामों को उनके BSON प्रकारों के साथ सूचीबद्ध करता है।
फ़ील्ड खोज एक नमूने से काम करती है, जो स्कीमालेस स्टोर में मायने रखता है: यदि पहले दस्तावेज़ों में कोई फ़ील्ड नहीं है जो बाद के दस्तावेज़ों में है, तो वह सूची में नहीं दिखाई देगा। यदि आप जानते हैं कि वह मौजूद है तो उसे बाइंडिंग में मैन्युअल रूप से जोड़ें।
चरण 3 - फ़िल्टर कैसे निष्पादित होता है
फ़िल्टर पंक्ति जो आप क्वेरी में बनाते हैं - कॉलम, ऑपरेटर, मान - MongoDB फ़िल्टर दस्तावेज़ में अनुवादित होती है और एजेंट द्वारा निष्पादित होती है:
| UI में ऑपरेटर | MongoDB |
|---|---|
शामिल है | { ean: { $regex: "40063813" } } |
से शुरू | { ean: { $regex: "^40063813" } } |
= | { ean: "40063813" } |
> / < | { price: { $gt: 10 } } / { $lt: … } |
दो परिणाम जो स्पष्ट रूप से कहने लायक हैं:
- कोई इंजेक्शन सतह नहीं है। MongoDB फ़िल्टर एक BSON दस्तावेज़ है - डेटा, कोड के रूप में पार्स की जाने वाली स्ट्रिंग नहीं।
$या{}वाला मान अभी भी सिर्फ एक मान है। - बिना एंकर के
$regexइंडेक्स का उपयोग नहीं कर सकता। बड़े collection परशामिल हैपूर्ण स्कैन है।से शुरू^…उत्पन्न करता है, जिसे उस फ़ील्ड पर सामान्य इंडेक्स पूरा कर सकता है। बड़े collection पर इसे प्राथमिकता दें।
कठोर सीमाएँ (एजेंट स्रोत से)
| सीमा | मान |
|---|---|
| प्रति अनुरोध पंक्तियाँ | 1000 - limit क्लैम्प्ड है, डिफ़ॉल्ट 100 |
| सर्वर चयन टाइमआउट | 15 s - अप्राप्य रेप्लिका सेट यहाँ विफल होता है, मिनटों के बाद नहीं |
| निष्पादित ऑपरेशन | केवल पढ़ना: सॉर्ट, स्किप और लिमिट के साथ Find |
बड़े परिणाम सेट पेजिनेटेड होते हैं: प्लेटफ़ॉर्म बढ़ते Skip के साथ पेज दर पेज अनुरोध करता है, प्रत्येक 1000 दस्तावेज़ों पर सीमित। इसलिए 10 000 लेबल बैच प्रिंट करना कभी भी किसी भी तरफ मेमोरी में एक पेज से अधिक नहीं रखता।
ध्यान दें कि बड़े ऑफ़सेट पर Skip MongoDB को छोड़े गए दस्तावेज़ों पर चलने के लिए बाध्य करता है। सैकड़ों हज़ारों के कैटलॉग के लिए, एक अनुक्रमित सॉर्ट फ़ील्ड उसे सस्ता रखती है; अनुक्रमित सॉर्ट नहीं रखेगी।
चरण 4 - डिज़ाइनर और Print Views में उपयोग करें
- डिज़ाइनर → परीक्षण डेटा टैब → डेटा स्रोत: डेटासोर्स चुनें, लोड दबाएँ, और हर बाइंडिंग वास्तविक दस्तावेज़ों के साथ रेंडर होती है। फ़ील्ड लंबाई, लापता मान और एन्कोडिंग समस्याएँ यहाँ दिखती हैं न कि लेबल रोल पर।
- Print Views → कॉन्फ़िगरेशन → डेटा स्रोत (डेटा हब): पूर्वावलोकन और प्रिंटिंग लाइव क्वेरी का उपयोग करते हैं। ऑपरेटर कभी नहीं देखता कि पीछे MongoDB है।
विफलता मोड
| लक्षण | कारण |
|---|---|
| एजेंट चलता है, डेटा हब में कोई चिप नहीं | --mongo नाम लापता, या API कुंजी दूसरे workspace की है |
परीक्षण ~15 s के बाद विफल | सर्वर चयन टाइमआउट - एजेंट मशीन से होस्ट अप्राप्य, गलत पोर्ट, या रेप्लिका सेट जिसके सदस्य ऐसे नाम घोषित करते हैं जिन्हें एजेंट हल नहीं कर सकता |
परीक्षण तुरंत auth त्रुटि से विफल | गलत उपयोगकर्ता/पासवर्ड, या प्रमाणीकरण डेटाबेस डेटा डेटाबेस से भिन्न है (?authSource=admin) |
फ़ील्ड एक फ़ील्ड चूक जाता है | नमूना दस्तावेज़ में वह नहीं है - स्कीमालेस collection को प्रतिनिधि नमूना चाहिए |
| दिखने वाले मान पर फ़िल्टर कुछ नहीं लौटाता | प्रकार बेमेल: स्ट्रिंग से तुलना किया गया संख्यात्मक फ़ील्ड। फ़ील्ड सूची में प्रकार जाँचें |
योजना
डेटा हब (CLI एजेंट के माध्यम से MongoDB और SQL Server डेटासोर्स) Pro योजना का हिस्सा है। मूल्य पृष्ठ देखें।