



zplCloud Blog
MongoDB 作为数据源:无需导出,云中无副本
筛选条件变成原生查询文档,由你网络中的 agent 执行。连接字符串始终留在你的机器上。
无需导出,你的 collection 在云端没有副本
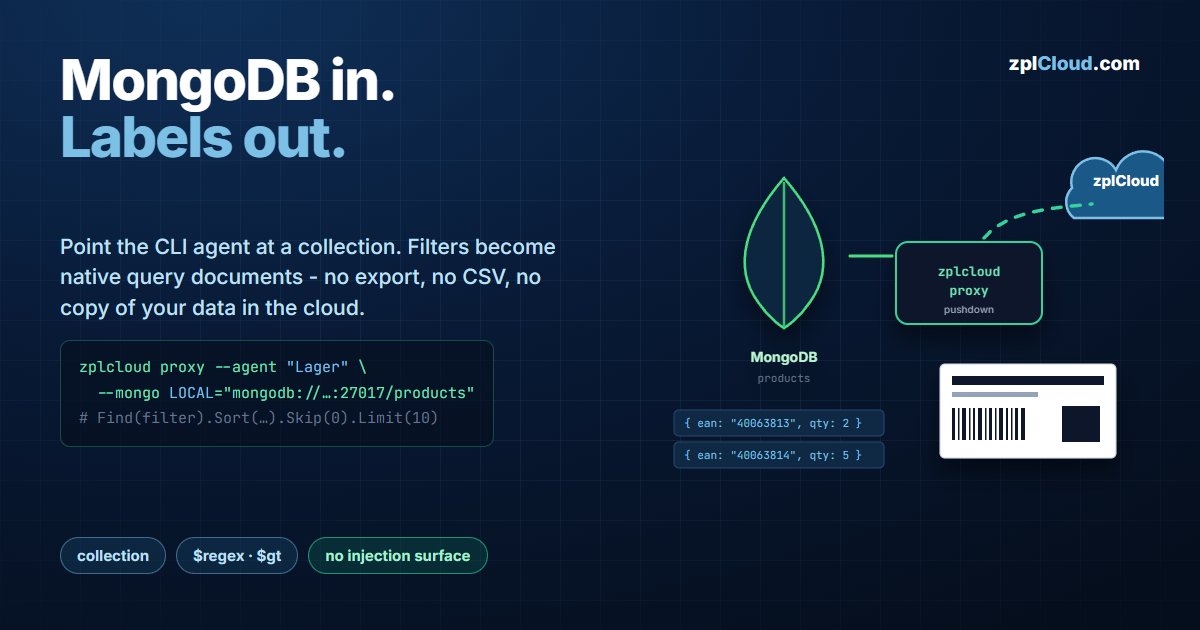
产品数据、订单条目、序列号——如果它们已经存在于 MongoDB,为打印标签而导出 CSV 纯粹是额外开销,而且导出在写下的那一刻就已过时。
zplCloud data hub 直接连接 collection。你网络中的 CLI agent 持有连接字符串,平台描述查询,agent 只返回匹配的文档。数据库保持对互联网不可达。
架构
zplcloud proxy 保持一条到 api.zplcloud.com 的出站 TLS 连接。你这边没有任何监听,所以没有入站端口、没有防火墙例外。查询、排序和分页被下推:agent 构建真正的 MongoDB 查询并调用 Find(filter).Sort(…).Skip(n).Limit(m)。collection 从不被下载。
第 1 步 - 用你的 MongoDB 启动 agent
# 允许多个 --mongo 标志;NAME 是你在平台中选择的名称。
zplcloud proxy --agent "Lager" \
  --mongo LOCAL="mongodb://admin:…@127.0.0.1:27017/products" \
  --mongo PROD="mongodb://admin:…@mongo.internal.lan:27017/erp"
连接字符串必须包含数据库名——它是 host 之后的部分,…:27017/products。没有它,agent 只有服务器,没有可查询的数据库。
秘密最好不进 shell 历史:
$env:ZPLCLOUD_MONGO_LOCAL_CONNECTION = "mongodb://admin:…@127.0.0.1:27017/products"
zplcloud proxy --agent "Lager"
横幅确认已注册内容:MongoDB servers: LOCAL, PROD。用 --api-key <key> 或 ZPLCLOUD_API_KEY 向平台认证;用 --service-install(Linux/Raspberry Pi 上的 systemd、Windows 上的计划任务)或 docker-compose.agent.yml 中的 ZPLCLOUD_MONGO_LOCAL_CONNECTION 使其持久化。
给 agent 一个只读用户,限定在它需要的数据库。agent 用该用户执行,因此 MongoDB 自己的角色模型就是权限边界。
第 2 步 - 创建数据源
在数据源中,agent 出现在 Remote SQL Server 下,每个 MongoDB 实例一个芯片。点击它会预填表单。
| 字段 | 值 |
|---|---|
| 名称 | Lager-Artikel |
| 类型 | MongoDB |
| 服务器 | LOCAL(--mongo LOCAL=… 中的名称) |
| Collection | products |
测试对实例做 ping 并返回 server · database。字段采样一个文档并列出字段名及其 BSON 类型。
字段发现基于样本工作,这在无模式存储中很重要:如果前几个文档没有后续文档才有的字段,它不会出现在列表中。如果你知道它存在,就在 binding 中手动添加。
第 3 步 - 过滤器如何执行
你在查询中构建的过滤行 - 列、操作符、值 - 会被翻译成 MongoDB 过滤器文档并由 agent 执行:
| UI 中的操作符 | MongoDB |
|---|---|
包含 | { ean: { $regex: "40063813" } } |
以…开头 | { ean: { $regex: "^40063813" } } |
= | { ean: "40063813" } |
> / < | { price: { $gt: 10 } } / { $lt: … } |
两个值得直说的后果:
- 没有注入面。 MongoDB 过滤器是 BSON 文档——是数据,不是被解析为代码的字符串。包含
$或{}的值仍然只是值。 - 没有锚点的
$regex无法使用索引。 在大 collection 上做包含是全表扫描。以…开头产生^…,该字段上的普通索引可以提供。在大 collection 上,优先使用它。
硬性限制(来自 agent 源码)
| 限制 | 值 |
|---|---|
| 每次请求行数 | 1000 - limit 被钳制,默认 100 |
| 服务器选择超时 | 15 s - 不可达的副本集在这里失败,而不是数分钟后 |
| 执行的操作 | 只读:带 sort、skip 和 limit 的 Find |
更大的结果集会分页:平台用递增的 Skip 一页页请求,每页上限 1000 个文档。因此批量打印 10 000 张标签在任何一侧都从不在内存中保留超过一页。
注意:在大的 offset 上使用 Skip 会让 MongoDB 走过被跳过的文档。对于数十万级的目录,索引排序字段能让它保持廉价;未索引的排序则不行。
第 4 步 - 在设计器和 Print Views 中使用
- 设计器 → 测试数据 选项卡 → 数据源: 选择数据源,按加载,每个 binding 用真实文档渲染。字段长度、缺失值和编码问题在这里出现,而不是出现在标签卷上。
- Print Views → 配置 → 数据源(Data Hub): 预览和打印使用实时查询。操作员永远不会看到背后是 MongoDB。
故障模式
| 症状 | 原因 |
|---|---|
| agent 在运行,data hub 中没有芯片 | --mongo 名称缺失,或 API 密钥属于另一个 workspace |
测试 在 ~15 s 后失败 | 服务器选择超时 - 从 agent 机器上 host 不可达、端口错误,或副本集成员公布的名字 agent 无法解析 |
测试 立即以 auth 错误失败 | 用户/密码错误,或认证数据库与数据数据库不同(?authSource=admin) |
字段 漏掉一个字段 | 采样的文档不含它 - 无模式 collection 需要代表性样本 |
| 过滤器在你可见的值上无返回 | 类型不匹配:数字字段与字符串比较。在字段列表中检查类型 |
套餐
data hub(通过 CLI agent 的 MongoDB 和 SQL Server 数据源)属于 Pro 套餐。参见定价页面。