



zplCloud Blog
MongoDB comme source de données : sans export, sans copie dans le cloud
Les filtres deviennent des documents de requête MongoDB natifs, exécutés par l'agent dans votre réseau. La chaîne de connexion reste sur votre machine.
Sans export, sans copie de votre collection dans le cloud
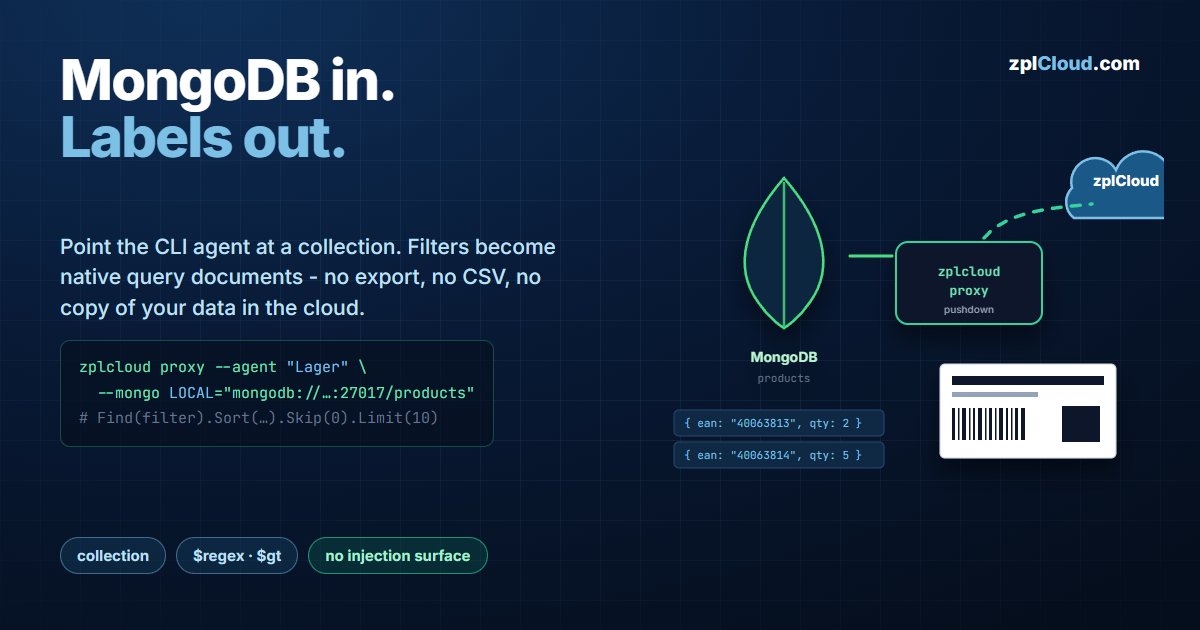
Données produit, articles de commande, numéros de série - si elles vivent déjà dans MongoDB, les exporter en CSV pour qu'une étiquette puisse les imprimer est une pure surcharge, et l'export est obsolète au moment même où il est écrit.
Le data hub zplCloud connecte la collection directement. Un agent CLI dans votre réseau détient la chaîne de connexion, la plateforme décrit la requête, et l'agent ne renvoie que les documents correspondants. La base de données reste inaccessible depuis internet.
Architecture
zplcloud proxy maintient une connexion TLS sortante vers api.zplcloud.com. Rien n'écoute de votre côté, donc pas de port entrant ni d'exception de pare-feu. La requête, le tri et la pagination sont poussés vers le bas : l'agent construit une vraie requête MongoDB et appelle Find(filter).Sort(…).Skip(n).Limit(m). La collection n'est jamais téléchargée.
Étape 1 - démarrez l'agent avec votre MongoDB
# Plusieurs drapeaux --mongo sont autorisés ; le NOM est ce que vous choisissez dans la plateforme.
zplcloud proxy --agent "Lager" \
  --mongo LOCAL="mongodb://admin:…@127.0.0.1:27017/products" \
  --mongo PROD="mongodb://admin:…@mongo.internal.lan:27017/erp"
La chaîne de connexion doit inclure le nom de la base de données - c'est la partie après l'hôte, …:27017/products. Sans elle, l'agent a un serveur mais aucune base à interroger.
Il vaut mieux garder les secrets hors de l'historique du shell :
$env:ZPLCLOUD_MONGO_LOCAL_CONNECTION = "mongodb://admin:…@127.0.0.1:27017/products"
zplcloud proxy --agent "Lager"
La bannière confirme ce qui a été enregistré : MongoDB servers: LOCAL, PROD. Authentifiez-vous auprès de la plateforme avec --api-key <key> ou ZPLCLOUD_API_KEY ; rendez-le permanent avec --service-install (systemd sur Linux/Raspberry Pi, tâche planifiée sur Windows) ou avec ZPLCLOUD_MONGO_LOCAL_CONNECTION dans docker-compose.agent.yml.
Donnez à l'agent un utilisateur en lecture seule limité à la base dont il a besoin. L'agent exécute avec cet utilisateur, donc le modèle de rôles propre de MongoDB est la frontière des permissions.
Étape 2 - créez la source de données
Dans Sources de données, l'agent apparaît sous Remote SQL Server avec une puce par instance MongoDB. Cliquer dessus pré-remplit le formulaire.
| Champ | Valeur |
|---|---|
| Nom | Lager-Artikel |
| Type | MongoDB |
| Serveur | LOCAL (le nom de --mongo LOCAL=…) |
| Collection | products |
Tester fait un ping à l'instance et renvoie serveur · base de données. Champs échantillonne un document et liste les noms de champs avec leurs types BSON.
La découverte des champs fonctionne à partir d'un échantillon, ce qui compte dans un stockage sans schéma : si les premiers documents n'ont pas un champ que des documents ultérieurs ont, il n'apparaîtra pas dans la liste. Ajoutez-le manuellement dans le binding si vous savez qu'il existe.
Étape 3 - comment un filtre est exécuté
La ligne de filtre que vous construisez dans Requête - colonne, opérateur, valeur - est traduite en document de filtre MongoDB et exécutée par l'agent :
| Opérateur dans l'UI | MongoDB |
|---|---|
contient | { ean: { $regex: "40063813" } } |
commence par | { ean: { $regex: "^40063813" } } |
= | { ean: "40063813" } |
> / < | { price: { $gt: 10 } } / { $lt: … } |
Deux conséquences qui méritent d'être dites clairement :
- Il n'y a pas de surface d'injection. Un filtre MongoDB est un document BSON - des données, pas une chaîne analysée comme du code. Une valeur contenant
$ou{}reste juste une valeur. $regexsans ancre ne peut pas utiliser d'index.contientsur une grande collection est un scan complet.commence parproduit^…, qu'un index normal sur ce champ peut servir. Sur les grandes collections, préférez-le.
Les limites dures (du code source de l'agent)
| Limite | Valeur |
|---|---|
| Lignes par requête | 1000 - limit est plafonné, le défaut est 100 |
| Délai de sélection de serveur | 15 s - un replica set injoignable échoue ici, pas après des minutes |
| Opération exécutée | lecture seule : Find avec sort, skip et limit |
Les jeux de résultats plus grands sont paginés : la plateforme demande page après page avec un Skip croissant, chacune plafonnée à 1000 documents. L'impression par lots de 10 000 étiquettes ne garde donc jamais plus d'une page en mémoire, d'aucun côté.
Notez que Skip sur un grand offset fait parcourir à MongoDB les documents sautés. Pour des catalogues de centaines de milliers d'entrées, un champ de tri indexé garde cela bon marché ; un tri non indexé ne le fera pas.
Étape 4 - utilisez-le dans le designer et dans les Print Views
- Designer → onglet Données de test → Source de données : choisissez la source de données, appuyez sur Charger, et chaque binding se rend avec de vrais documents. Les longueurs de champs, les valeurs manquantes et les problèmes d'encodage apparaissent ici plutôt que sur le rouleau d'étiquettes.
- Print Views → configuration → Source de données (data hub) : l'aperçu et l'impression utilisent la requête en direct. L'opérateur ne voit jamais que MongoDB est derrière.
Modes d'échec
| Symptôme | Cause |
|---|---|
| L'agent tourne, pas de puce dans le data hub | nom --mongo manquant, ou la clé API appartient à un autre workspace |
Tester échoue après ~15 s | délai de sélection de serveur - hôte injoignable depuis la machine de l'agent, mauvais port, ou replica set dont les membres annoncent des noms que l'agent ne peut pas résoudre |
Tester échoue instantanément avec erreur d'auth | mauvais utilisateur/mot de passe, ou la base d'authentification diffère de la base de données (?authSource=admin) |
Champs rate un champ | le document échantillonné ne le contient pas - les collections sans schéma ont besoin d'un échantillon représentatif |
| Le filtre ne renvoie rien sur une valeur visible | décalage de type : un champ numérique comparé à une chaîne. Vérifiez le type dans la liste des champs |
Plan
Le data hub (sources de données MongoDB et SQL Server via l'agent CLI) fait partie du plan Pro. Voir la page de prix.