



zplCloud Blog
MongoDB come sorgente dati: senza export, senza copia nel cloud
I filtri diventano documenti di query nativi, eseguiti dall'agente nella tua rete. La stringa di connessione resta sulla tua macchina.
Senza export, senza copia della tua collection nel cloud
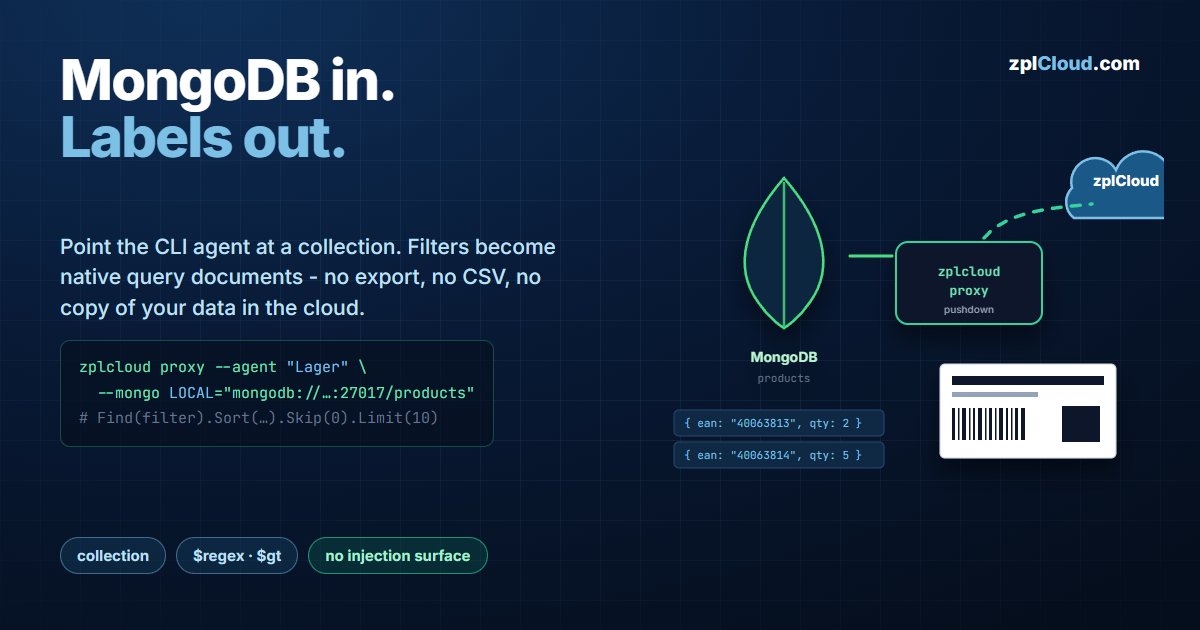
Dati prodotto, righe d'ordine, numeri di serie - se vivono già in MongoDB, esportarli in CSV perché un'etichetta possa stamparli è pura overhead, e l'export è obsoleto nel momento stesso in cui viene scritto.
Il data hub zplCloud collega la collection direttamente. Un agente CLI nella tua rete detiene la stringa di connessione, la piattaforma descrive la query, e l'agente restituisce solo i documenti corrispondenti. Il database resta irraggiungibile da internet.
Architettura
zplcloud proxy mantiene una connessione TLS in uscita verso api.zplcloud.com. Nulla è in ascolto dalla tua parte, quindi niente porte in ingresso né eccezioni firewall. Query, ordinamento e paginazione vengono spinti verso il basso: l'agente costruisce una vera query MongoDB e chiama Find(filter).Sort(…).Skip(n).Limit(m). La collection non viene mai scaricata.
Passo 1 - avvia l'agente con il tuo MongoDB
# Sono ammessi più flag --mongo; il NOME è ciò che scegli nella piattaforma.
zplcloud proxy --agent "Lager" \
  --mongo LOCAL="mongodb://admin:…@127.0.0.1:27017/products" \
  --mongo PROD="mongodb://admin:…@mongo.internal.lan:27017/erp"
La stringa di connessione deve includere il nome del database - è la parte dopo l'host, …:27017/products. Senza, l'agente ha un server ma nessun database da interrogare.
È meglio tenere i segreti fuori dalla cronologia della shell:
$env:ZPLCLOUD_MONGO_LOCAL_CONNECTION = "mongodb://admin:…@127.0.0.1:27017/products"
zplcloud proxy --agent "Lager"
Il banner conferma cosa è stato registrato: MongoDB servers: LOCAL, PROD. Autenticati sulla piattaforma con --api-key <key> o ZPLCLOUD_API_KEY; rendilo permanente con --service-install (systemd su Linux/Raspberry Pi, attività pianificata su Windows) o con ZPLCLOUD_MONGO_LOCAL_CONNECTION in docker-compose.agent.yml.
Dai all'agente un utente di sola lettura limitato al database che gli serve. L'agente esegue con quell'utente, quindi il modello di ruoli di MongoDB stesso è il confine dei permessi.
Passo 2 - crea la sorgente dati
In Origini dati l'agente appare sotto Remote SQL Server con un chip per istanza MongoDB. Cliccandolo si precompila il modulo.
| Campo | Valore |
|---|---|
| Nome | Lager-Artikel |
| Tipo | MongoDB |
| Server | LOCAL (il nome di --mongo LOCAL=…) |
| Collection | products |
Test esegue un ping all'istanza e restituisce server · database. Campi campiona un documento ed elenca i nomi dei campi con i loro tipi BSON.
La scoperta dei campi funziona da un campione, il che conta in uno store senza schema: se i primi documenti non hanno un campo che documenti successivi hanno, non apparirà nell'elenco. Aggiungilo manualmente nel binding se sai che esiste.
Passo 3 - come viene eseguito un filtro
La riga di filtro che costruisci in Query - colonna, operatore, valore - viene tradotta in un documento di filtro MongoDB ed eseguita dall'agente:
| Operatore nella UI | MongoDB |
|---|---|
contiene | { ean: { $regex: "40063813" } } |
inizia con | { ean: { $regex: "^40063813" } } |
= | { ean: "40063813" } |
> / < | { price: { $gt: 10 } } / { $lt: … } |
Due conseguenze che vale la pena dire chiaramente:
- Non c'è superficie di injection. Un filtro MongoDB è un documento BSON - dati, non una stringa analizzata come codice. Un valore contenente
$o{}è solo un valore. $regexsenza ancora non può usare un indice.contienesu una grande collection è una scansione completa.inizia conproduce^…, che un indice normale su quel campo può servire. Su grandi collection, preferiscilo.
I limiti duri (dal codice sorgente dell'agente)
| Limite | Valore |
|---|---|
| Righe per richiesta | 1000 - limit è limitato, il default è 100 |
| Timeout di selezione server | 15 s - un replica set irraggiungibile fallisce qui, non dopo minuti |
| Operazione eseguita | sola lettura: Find con sort, skip e limit |
I set di risultati più grandi vengono paginati: la piattaforma richiede pagina dopo pagina con uno Skip crescente, ciascuna limitata a 1000 documenti. La stampa batch di 10 000 etichette non tiene quindi mai più di una pagina in memoria, da nessuna parte.
Nota che Skip su un grande offset fa camminare a MongoDB i documenti saltati. Per cataloghi di centinaia di migliaia di voci, un campo di ordinamento indicizzato mantiene tutto economico; un sort non indicizzato no.
Passo 4 - usalo nel designer e nelle Print Views
- Designer → scheda Dati di prova → Origine dati: scegli la sorgente dati, premi Carica, e ogni binding si renderizza con documenti reali. Le lunghezze dei campi, i valori mancanti e i problemi di codifica appaiono qui piuttosto che sul rotolo di etichette.
- Print Views → configurazione → Origine dati (Data Hub): l'anteprima e la stampa usano la query live. L'operatore non vede mai che dietro c'è MongoDB.
Modalità di errore
| Sintomo | Causa |
|---|---|
| L'agente gira, nessun chip nel data hub | nome --mongo mancante, o la chiave API appartiene a un altro workspace |
Test fallisce dopo ~15 s | timeout di selezione server - host irraggiungibile dalla macchina dell'agente, porta sbagliata, o un replica set i cui membri annunciano nomi che l'agente non può risolvere |
Test fallisce all'istante con errore di auth | utente/password sbagliati, o il database di autenticazione differisce da quello dei dati (?authSource=admin) |
Campi perde un campo | il documento campionato non lo contiene - le collection senza schema hanno bisogno di un campione rappresentativo |
| Il filtro non restituisce nulla su un valore che vedi | disallineamento di tipo: un campo numerico confrontato con una stringa. Controlla il tipo nell'elenco campi |
Piano
Il data hub (sorgenti dati MongoDB e SQL Server tramite l'agente CLI) fa parte del piano Pro. Vedi la pagina prezzi.