



zplCloud Blog
Visualizador online, ferramenta desktop ou script local? A pergunta melhor: onde roda o seu pipeline de etiquetas?
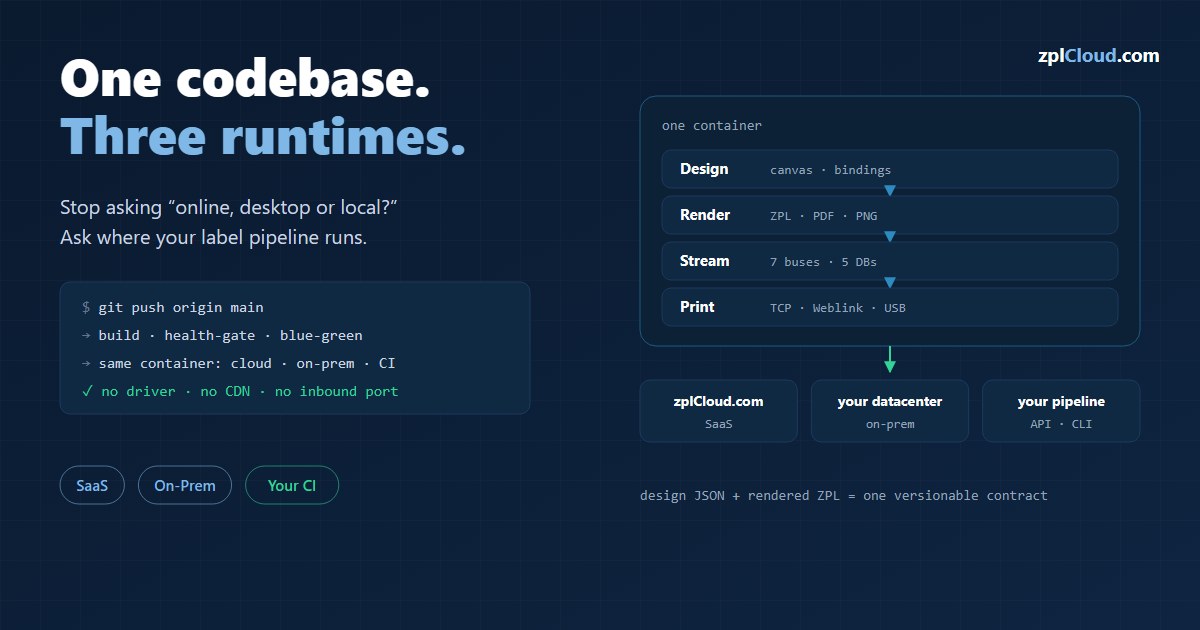
O debate "online vs. desktop vs. local" termina quando design, renderização, streaming e impressão vivem em um único contêiner - na nuvem, on-prem ou no seu próprio datacenter, implantado com um git push.
Online, desktop ou local - a pergunta errada
Quem trabalha com etiquetas Zebra conhece o momento: no código a etiqueta parece certa, mas sai impressa deslocada, girada, cortada - ou com um código de barras que não escaneia. A resposta usual é uma pergunta sobre o tipo de ferramenta: um visualizador online pela rapidez e pela colaboração, uma ferramenta desktop para uso offline e redes restritivas, um script local de desenvolvimento para desenvolvedores que ficam perto do código. Acrescente alguns critérios - segurança, colaboração, velocidade de depuração, restrições de TI, volume - e a decisão está tomada.
É um enquadramento que funciona. Para um visualizador.
O zplCloud responde à mesma pergunta de outra forma. Não comparamos "qual janela me mostra a etiqueta"; perguntamos "onde roda todo o caminho do evento de dados até a etiqueta física?". E aí o "ou" vira "e": o zplCloud é ao mesmo tempo um visualizador na nuvem, uma ferramenta desktop e uma ferramenta local - porque design, renderização, streaming e impressão ficam em um único contêiner, que você inicia onde estão seus dados e suas impressoras. A pergunta deixa de ser "que tipo de ferramenta?" e passa a ser "em qual ambiente eu implanto o pipeline?"
A mudança em uma tabela
| A divisão usual | A resposta do zplCloud |
|---|---|
| Visualizador online / na nuvem | zplCloud.com como SaaS - sem instalação: abra o navegador, renderize uma etiqueta, compartilhe |
| Visualizador desktop (offline, restritivo) | o mesmo contêiner on-prem - seu datacenter, seu firewall, controle total |
| Ferramentas locais de desenvolvimento (perto do código) | API + CLI + visualização de código - renderize no seu próprio CI, por um pipeline git, curl ou zplcloud send |
Não são três produtos. Uma base de código, três ambientes de execução. É exatamente por isso que a lógica de decisão clássica pode ser virada de cabeça para baixo: em vez de "qual tipo de ferramenta se encaixa na minha restrição?", a pergunta passa a ser "qual restrição eu tenho - e em qual host o contêiner roda para atendê-la?".
Renderizar primeiro, imprimir depois - com o mecanismo real
O erro mais comum em projetos de etiquetas é tratar "renderiza" como se fosse "imprime corretamente". O zplCloud fecha essa lacuna usando o mesmo mecanismo para a pré-visualização e para a impressão.
- O designer renderiza a pré-visualização em PNG/PDF/SVG/ZPL no seu próprio backend - sem serviço de renderização externo, sem chamada em tempo de execução a uma CDN externa (para nós, uma regra rígida, tanto por compliance quanto por disponibilidade).
- O que você vê na pré-visualização é, byte por byte, o que depois vai para a impressora como ZPL (
^XA…^XZ). Uma renderização a 203 dpi é uma renderização a 203 dpi - código de barras, QR, fonte TrueType, tudo a partir de uma única origem. - O mecanismo é construído como uma API com suporte a lotes:
POST /api/zpl,/api/render/png,/api/render/pdf,/api/export/console. Um design mais N registros é igual a N etiquetas - sem clicar etiqueta por etiqueta. - Desempenho é um princípio de design, não um recurso: a renderização roda dentro do processo do contêiner, escala horizontalmente (mais réplicas, mais throughput de renderização) e pode ser medida em qualquer ambiente com a imagem perftest incluída (
scripts/perftest.sh, modoszpl/pdf/png/zpl-api) - um teste de carga antes do go-live, em vez de esperança depois.
Essa é a resposta para "volume e regressão": quem produz muitas variantes de etiqueta de forma programática (modelos, campos dinâmicos, muitos SKUs) não precisa de uma janela de visualizador, precisa de um caminho de renderização repetível - e aqui isso é uma chamada de API, não uma captura de tela.
Eventos em vez de um botão: streaming de dados e de eventos
Um visualizador é, antes de tudo, um controle de qualidade antes da impressão. Na logística real, porém, a impressão costuma ser a consequência de um evento: um evento de pedido, uma tarefa de separação, um número de série vindo do MES, uma linha do ERP.
O zplCloud transforma o evento diretamente no gatilho de impressão. Sete barramentos de mensagens o alimentam:
- Apache Kafka - assine um tópico; cada mensagem é renderizada com um design de etiqueta e enviada a uma impressora. Modo cloud (broker na internet, Confluent ou MSK, por exemplo) ou modo on-prem (broker atrás do seu firewall, consumido pelo agente CLI - as credenciais do broker nunca saem da sua rede).
- Azure Service Bus, MQTT, AMQP 1.0, RabbitMQ, Amazon SQS e Google Pub/Sub - a mesma mecânica para todos os outros ambientes. O MQTT é o que importa no chão de fábrica, onde balanças, scanners e CLPs já estão ligados ao broker.
- Fontes do hub de dados - SQL Server, MongoDB, PostgreSQL, MySQL e MariaDB. Consulta com pushdown pelo agente CLI: a consulta roda on-prem e só o resultado viaja até a plataforma. Bancos de dados na nuvem que sejam acessíveis também podem ser conectados diretamente, sem nenhum agente.
E aqui está a parte em que a maioria das integrações de streaming fica vaga, então vamos ser precisos:
- O consumidor confirma a mensagem somente após uma impressão bem-sucedida. A impressão falhou? O Kafka deixa o offset onde estava, o Service Bus abandona a mensagem e a envia para a fila de mensagens mortas (dead-letter) após três entregas, o MQTT simplesmente não confirma e o broker reentrega com QoS 1 ou 2. Nada é pulado em silêncio, nenhum loop infinito de tentativas.
- Erros de broker (inacessível, autenticação rejeitada, tópico removido) não são erros de impressão; por isso recebem backoff exponencial (de 5 s a 60 s), com o estado visível na interface.
- Um keepalive tira as impressoras Link-OS do modo de espera, para que a primeira etiqueta após uma pausa não seja atrasada pela latência de ativação.
Uma etiqueta que não foi impressa é um fato físico que alguém precisa ver. É essa semântica que garante isso - e essa é a diferença entre um visualizador e um pipeline.
Nas duas direções, incluindo o bucket
Os arquivos de impressão muitas vezes já estão em um object storage: etiquetas de transportadoras, lotes pré-renderizados, arquivamentos mantidos por regras de retenção. Assim, a mensagem do barramento nem precisa carregar o ZPL - ela pode apontar para ele:
{ "schemaVersion": 1, "printer": "*", "zplRef": { "storage": "archive", "key": "orders/4711.zpl" } }
O arquivo é buscado no S3 ou no Azure Blob no momento da impressão. E no sentido inverso: um destino de saída grava cada etiqueta impressa de volta em um bucket, envia uma mensagem para qualquer um dos sete barramentos e dispara um webhook assinado com HMAC - cada etapa ativada separadamente, todas depois da impressão, para que um bucket lento nunca segure a linha.
Uma interface própria para o chão de fábrica: Print Views
O outro lado da mesma moeda: nem toda etiqueta vem de um evento. Muitas vezes há uma pessoa na bancada de embalagem, na expedição, no armazém - e ela precisa de algo utilizável, não de um terminal.
Uma Print View é exatamente isso. A partir de um design salvo, a plataforma gera um formulário responsivo próprio, com seu próprio link:
https://print.zplcloud.com/d/{designKey}/{viewSlug}
O que isso significa para o fluxo de trabalho, e por que funciona em movimento:
- Mobile-first e PWA: cada visão traz seu próprio
manifest.jsone ícone de app. "Adicionar à tela inicial" transforma o link em um ícone de app no Android e no iOS que abre direto no formulário. Um app sem app store, sem instalação, sem drivers. - Um formulário, não um designer: campos de texto com validação, menus suspensos alimentados por uma fonte de dados, caixas de seleção. O operador preenche valores, não ZPL. Só os campos que você marcou como visíveis podem ser editados.
- Um botão de scanner ao lado de cada campo: toque na câmera e escaneie um código de barras ou QR direto no campo. É isso que decide se uma Print View sobrevive ao contato com a realidade - digitar um EAN de 13 dígitos no celular na bancada de embalagem não sobrevive.
- Pré-visualização ao vivo: uma pré-visualização em PDF é renderizada de novo enquanto você digita, com o mesmo mecanismo do servidor que produz o ZPL. O que está na tela é o que sai da impressora.
- Uma projeção, não um link de compartilhamento: os valores são validados no servidor, campos bloqueados nem estão no payload e o design em si nunca chega ao navegador. Quem tem a URL pode imprimir esta etiqueta - mas não consegue acessar a sua conta.
A impressão vai para uma impressora Weblink, para uma impressora remota no agente CLI ou para um PDF no diálogo de impressão local. E quando a visão está ligada a uma fonte do hub de dados, uma consulta parametrizada puxa a linha do seu ERP e pré-preenche o formulário - a variante DHL chega a comprar franqueamento real a partir de um ID de pedido e imprime o selo.
Isso cobre toda a gama: eventos disparam a impressão automaticamente, Print Views dão às pessoas em movimento uma interface segura e mínima - e ambos rodam no mesmo mecanismo de renderização, no mesmo contêiner.
O ponto principal: deploy por um pipeline git
Agora, a parte que responde à pergunta "online vs. desktop vs. local" em um nível completamente diferente: o deployment.
Um visualizador você instala. Uma plataforma de impressão você implanta - com a mesma ferramenta com que seus desenvolvedores já entregam código: git.
A sequência foi construída deliberadamente para dar certo todas as vezes:
1. Push em um branch é igual a deploy em um ambiente. dev vai para o ambiente de teste (zplcloud_test), main para produção (zplcloud). Os pipelines do Azure (backend/azure-pipelines-backend.yml, weblink/azure-pipelines-weblink.yml) são disparados pelo push no branch.
2. Build Docker a partir do repositório - uma imagem (frontend Angular mais API ASP.NET Core, baseada em aspnet:10 azurelinux3, amd64, cerca de 260 MB).
3. Deploy blue-green com health gate: o novo contêiner inicia sem portas no host, é verificado por um health check (/api/health) e só quando está saudável o antigo é removido. Se a verificação falhar, há rollback, e o contêiner antigo continua rodando intocado. Sem janela de indisponibilidade, sem cruzar os dedos.
4. Rollback é igual ao último estado verde. Como a tag da imagem é o build id, voltar atrás é um único docker run com a tag anterior - ou uma nova execução do pipeline no último commit.
Por que "sempre dá certo": a migração do banco de dados é aditiva e idempotente (novas tabelas, novas colunas anuláveis, scripts IF NOT EXISTS em backend/scripts/*.sql). Por isso o banco de dados pode ser migrado antes do deploy do código, e tanto o código antigo quanto o novo rodam sobre o novo schema. A ordem é sempre a mesma: backup, migrar, verificar, regenerar o EF, merge, deploy, smoke test.
E como tudo fica em um único contêiner, o ambiente de destino não importa:
- Sua própria nuvem ou datacenter: rode o contêiner em qualquer host Docker ou cluster Kubernetes.
- On-prem: o agente CLI (
zplcloud proxy --agent, ele próprio disponível como contêiner Docker) abre uma conexão de saída para a plataforma, no estilo TeamViewer - suas impressoras e brokers ficam atrás do firewall, sem conexão de entrada e sem VPN. - Contêiner Weblink: impressoras Zebra por um relay WebSocket (certificados de cliente mTLS), TCP 9100 - implantável separadamente, com seu próprio pipeline.
Um sistema que você distribui no seu ambiente por um pipeline git também pode ser auditado, versionado e repetido por um pipeline git. É isso que "escalar" realmente significa aqui: mais réplicas para mais throughput de renderização, mais agentes para mais unidades, mais ambientes para mais segurança.
Nenhum driver, em lugar nenhum
O driver é o clássico ponto de ruptura: drivers de impressora do Windows, DLLs de fabricantes, dependências do sistema operacional. O zplCloud contorna tudo isso, porque ZPL é texto.
- O caminho de impressão é um stream TCP 9100 bruto, um WebSocket ou USB - sem driver de impressora, sem software do fabricante no cliente.
- Independente de plataforma: o cliente é um navegador (Angular), o mecanismo é .NET em um contêiner Linux. Windows, macOS, Linux, tablet, Raspberry Pi - não importa, desde que rode um navegador ou um agente.
- Sem dependência em tempo de execução de CDNs externas: todos os assets (Tailwind CSS, fontes, WASM do scanner) são auto-hospedados. Atrás de um firewall sem internet, o sistema continua funcionando por completo.
Isso resolve o cenário "offline / TI restritiva" não com um visualizador desktop, mas rodando a própria plataforma localmente.
Cobrindo todos os fluxos de trabalho, do desenvolvedor ao fabricante
Em vez de "adequar o tipo de ferramenta às suas restrições", o zplCloud oferece uma plataforma para todos os portes - e o arco abrange todos eles:
- Desenvolvedores: designer com visualização de código (geração de código C#, round trip do design ao código), API (
/api/zpl,/api/render/*,/api/export/console), CLI (zplcloud send,proxy,firmware). Pré-visualização renderizada no CI, deploy por git - o mesmo fluxo de qualquer outro serviço. - Um pequeno escritório com selos: compre franqueamento DHL Internetmarke diretamente e imprima-o como ZPL na Zebra. Remetente e destinatário entram, a conta de franqueamento é debitada, o selo sai da impressora. Nenhuma máquina de franquear necessária.
- Impressora desktop / estação de trabalho única: conecte uma impressora USB ou de rede pelo agente, renderize e imprima localmente - sem a nuvem, se esse for o requisito.
- Empreendedores e autônomos: um design, uma Print View, uma impressora. Print Views baseadas em formulário como PWA móvel, para a etiqueta avulsa do dia a dia na bancada ou na estrada.
- Pequenas empresas: contas de equipe, designs compartilhados, o hub de dados (cinco bancos de dados mais planilhas), workspaces de clientes para 3PL, permissões por escopo.
- Logística: etiquetas Amazon FBA a partir de um CSV (FNSKU, caixa, palete), Print Views somente-DHL com busca por ID de pedido, execuções em lote.
- Fabricantes: eventos de ERP e MES via Kafka, MQTT ou Service Bus direto nas impressoras de produção - confirmados somente após a impressão, para que nenhuma etiqueta se perca.
O fio condutor: é sempre a mesma plataforma. Começar pequeno não significa trocar de categoria de ferramenta depois; significa ativar a próxima etapa do mesmo pipeline.
Três sinais de que está funcionando
Como saber se o caminho da etiqueta realmente se encaixa? Três sinais:
1. Menos impressões de teste - porque a pré-visualização é idêntica ao mecanismo de impressão e os erros aparecem antes da etiqueta física.
2. Dev e ops falam sobre a mesma saída - porque a etiqueta é um JSON de design mais ZPL renderizado, um contrato compartilhado e versionável, e não uma captura de tela.
3. Mudanças em modelos param de surpreender - porque a revisão é repetível (mesma renderização, mesmo mecanismo, mesmo ambiente) e um deploy pelo pipeline é um passo rastreável e com possibilidade de rollback.
Um visualizador evita erros. Um pipeline torna o caminho do evento até a etiqueta determinístico - e essa, no fim, é a diferença que toda essa categorização estava tentando alcançar.