



zplCloud Blog
Online-Viewer, Desktop-Tool oder lokales Skript? Die bessere Frage: Wo läuft deine Label-Pipeline?
Der Vergleich „Online vs. Desktop vs. lokal" endet, wenn Design, Rendering, Streaming und Druck in einem Container laufen - Cloud, On-Prem oder im eigenen Rechenzentrum, deploybar per Git-Push.
Online, Desktop oder lokal - die falsche Frage
Wer mit Zebra-Etiketten arbeitet, kennt den Moment: Das Label sieht im Code richtig aus, druckt dann aber verschoben, gedreht, abgeschnitten - oder mit einem Barcode, der nicht scannt. Die übliche Antwort darauf ist die Frage nach dem passenden Werkzeug-Typ: Online-Viewer für Geschwindigkeit und Zusammenarbeit, Desktop-Tool für Offline und restriktive Netze, lokales Dev-Skript für Entwickler, die nah am Code bleiben. Dazu ein paar Kriterien - Sicherheit, Collaboration, Debug-Speed, IT-Zwänge, Volumen - und fertig ist die Entscheidung.
Das ist ein brauchbarer Rahmen. Für einen Viewer.
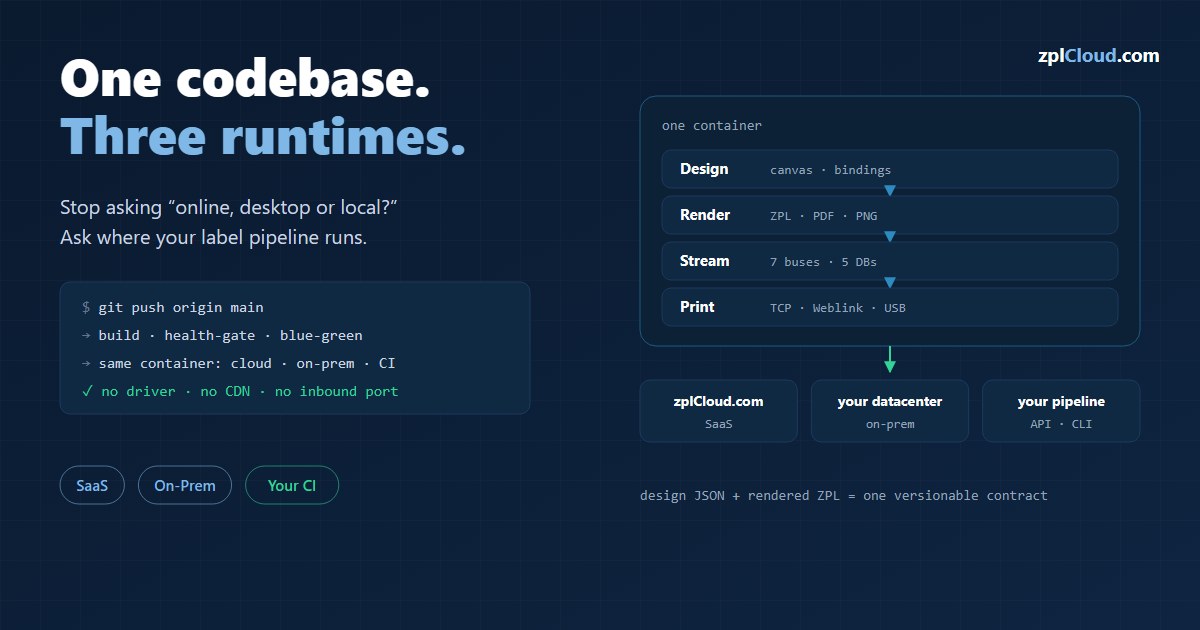
zplCloud beantwortet dieselbe Frage anders: Wir vergleichen nicht „welches Fenster zeigt mir das Label an", sondern „wo läuft die komplette Strecke vom Datenereignis bis zum physischen Etikett?". Und dort wird aus dem Entweder-oder ein Und: zplCloud ist zugleich Cloud-Viewer, Desktop-Tool und lokales Werkzeug - weil Design, Rendering, Streaming und Druck in einem Container stecken, den du dort startest, wo deine Daten und Drucker sind. Die Frage ist nicht mehr „welcher Tool-Typ?", sondern „in welcher Umgebung deploye ich die Pipeline?"
Der Perspektivwechsel in einer Tabelle
| Die übliche Einteilung | zplCloud-Antwort |
|---|---|
| Online/Cloud-Viewer | zplCloud.com als SaaS - kein Install, Browser auf, Label rendern, teilen |
| Desktop-Viewer (offline, restriktiv) | derselbe Container On-Prem - eigenes Rechenzentrum, eigene Firewall, volle Kontrolle |
| Lokale Dev-Tools (nah am Code) | API + CLI + Code-View - Rendern im eigenen CI, per Git-Pipeline, curl oder zplcloud send |
Nicht drei Produkte. Eine Codebasis, drei Laufzeitformen. Genau deshalb lässt sich die klassische Entscheidungslogik auf den Kopf stellen: Statt „welcher Tool-Typ passt zu meiner Einschränkung?" heißt es „welche Einschränkung habe ich - und auf welchem Host läuft der Container dafür?".
Erst rendern, dann drucken - und zwar mit der echten Engine
Der häufigste Fehler in Label-Projekten: „Es rendert" wird mit „es druckt richtig" verwechselt. Genau diese Lücke schließt zplCloud dadurch, dass Vorschau und Druck dieselbe Engine benutzen.
- Der Designer rendert PNG/PDF/SVG/ZPL-Vorschau im eigenen Backend - kein externer Render-Dienst, kein externer CDN-Aufruf zur Laufzeit (für uns aus Compliance- und Verfügbarkeitsgründen eine harte Regel).
- Was du in der Vorschau siehst, ist byte-identisch das, was später als ZPL (
^XA…^XZ) an den Drucker geht. Ein 203-dpi-Rendering ist ein 203-dpi-Rendering - Barcode, QR, TrueType-Font, alles aus einer Quelle. - Die Engine ist als Batch-fähige API ausgelegt:
POST /api/zpl,/api/render/png,/api/render/pdf,/api/export/console. Ein Design + N Records = N Labels - kein manuelles Klicken pro Etikett. - Performance ist kein Feature, sondern Bauprinzip: Das Rendering läuft im Container-Prozess, ist horizontal skalierbar (mehr Replicas = mehr Render-Durchsatz) und lässt sich mit dem mitgelieferten perftest-Image (
scripts/perftest.sh, Modizpl/pdf/png/zpl-api) gegen jede Stage nachmessen - Lasttest vor dem Go-Live statt Hoffnung danach.
Das ist die Antwort auf „Volumen & Regression": Wer programmatisch viele Label-Varianten erzeugt (Templates, dynamische Felder, viele SKUs), braucht kein Viewer-Fenster, sondern eine wiederholbare Render-Strecke - und die ist hier ein API-Call, kein Screenshot.
Events statt Knopfdruck: Data- und Event-Streaming
Ein Viewer ist in erster Linie ein Qualitäts-Gate vor dem Druck. In der echten Logistik ist der Druck aber meist Folge eines Ereignisses: ein Order-Event, ein Picking-Auftrag, eine Seriennummer aus dem MES, eine Zeile aus dem Warenwirtschaftssystem.
zplCloud macht aus dem Ereignis direkt den Druck-Trigger. Sieben Nachrichtenbusse liefern die Ereignisse:
- Apache Kafka - Topic abonnieren, jede Nachricht wird mit einem Label-Design gerendert und an einen Drucker gesendet. Cloud-Modus (Broker im Internet, z. B. Confluent/MSK) oder On-Prem-Modus (Broker hinter deiner Firewall, konsumiert vom CLI-Agenten - die Broker-Credentials verlassen dein Netz nie).
- Azure Service Bus, MQTT, AMQP 1.0, RabbitMQ, Amazon SQS und Google Pub/Sub - dieselbe Mechanik für jede andere Umgebung. MQTT ist der, auf den es in der Produktion ankommt, wo Waagen, Scanner und SPS ohnehin schon am Broker hängen.
- Datenhub-Datenquellen - SQL Server, MongoDB, PostgreSQL, MySQL und MariaDB. Lookup per Pushdown über den CLI-Agenten: Die Query läuft on-prem, nur das Ergebnis wandert zur Plattform. Erreichbare Cloud-Datenbanken bindet die Plattform auch direkt an, ganz ohne Agent.
Und hier ist der Teil, bei dem die meisten Streaming-Integrationen vage werden, deshalb in aller Präzision:
- Quittiert wird erst nach erfolgreichem Druck. Druck schlägt fehl? Kafka lässt den Offset stehen, Service Bus gibt die Nachricht zurück und legt sie nach drei Zustellungen ins Dead-Letter, MQTT quittiert schlicht nicht und der Broker stellt bei QoS 1 oder 2 erneut zu. Kein stilles Überspringen, keine Endlos-Retry-Schleife.
- Broker-Fehler (nicht erreichbar, Auth abgelehnt, Topic weg) sind kein Druckfehler und bekommen exponentielles Backoff (5 s bis 60 s), mit Status in der Oberfläche.
- Ein Keepalive weckt Link-OS-Drucker aus dem Standby, damit nach einer Pause nicht die Wake-up-Latenz das erste Etikett ausbremst.
Ein Etikett, das nicht gedruckt wurde, ist eine physische Tatsache, die jemand sehen muss. Genau das erzwingt diese Semantik - und das ist der Unterschied zwischen „Viewer" und „Pipeline".
Beide Richtungen, inklusive Bucket
Druckdateien liegen oft ohnehin schon im Objektspeicher: Carrier-Labels, vorgerenderte Chargen, Archive für die Aufbewahrungspflicht. Die Bus-Nachricht muss das ZPL also gar nicht tragen - sie kann darauf verweisen:
{ "schemaVersion": 1, "printer": "*", "zplRef": { "storage": "archiv", "key": "auftraege/4711.zpl" } }
Geholt wird die Datei erst beim Druck, aus S3 oder Azure Blob. Und umgekehrt: Ein Ausgabeziel schreibt jedes gedruckte Etikett zurück in einen Bucket, schickt eine Nachricht an einen der sieben Busse und löst einen HMAC-signierten Webhook aus - jeder Schritt einzeln zuschaltbar, alle nach dem Druck, damit ein langsamer Bucket nie die Linie aufhält.
Custom-User-Interfaces für unterwegs: Print Views
Die andere Seite derselben Münze: Nicht jede Etikette entsteht automatisch aus einem Event. Oft sitzt ein Mensch am Packtisch, am Versand, im Lager - und braucht eine bedienbare Oberfläche, kein Terminal.
Eine Print View ist genau das: Aus einem gespeicherten Design erzeugt die Plattform automatisch ein eigenes, responsives Formular mit eigenem Link:
https://print.zplcloud.com/d/{designKey}/{viewSlug}
Was das für den Workflow bedeutet - und warum es unterwegs funktioniert:
- Mobile-first und PWA: Jede View liefert ihr eigenes
manifest.json+ App-Icon aus. „Zum Startbildschirm hinzufügen" macht aus dem Link auf Android wie iOS ein App-Symbol, das direkt ins Formular führt. Eine App ohne App Store, ohne Installation, ohne Treiber. - Formular statt Designer: Textfelder mit Validierung, Dropdowns aus einer Datenquelle, Checkboxen - die Bedienung füllt Werte ein, nicht ZPL. Nur die Felder, die du als sichtbar markiert hast, sind editierbar.
- Scanner-Button neben jedem Feld: Kamera antippen, Barcode/QR direkt ins Feld scannen. Genau das entscheidet, ob eine Print View im Praxiskontakt überlebt - eine 13-stellige EAN am Packtisch auf dem Handy einzutippen, tut es nicht.
- Live-Vorschau: Eine PDF-Vorschau rendert beim Tippen neu - mit derselben serverseitigen Engine, die auch das ZPL erzeugt. Was auf dem Schirm steht, kommt aus dem Drucker.
- Projektion, kein Freigabelink: Werte werden serverseitig validiert, gesperrte Felder stehen gar nicht im Payload, und das Design selbst geht nie an den Browser. Wer die URL hat, darf dieses eine Etikett drucken - nicht auf dein Konto zugreifen.
Gedruckt wird wahlweise auf einen Weblink-Drucker, einen Remote-Drucker am CLI-Agenten oder als PDF in den lokalen Druckdialog. Und wenn die View an eine Datenhub-Datenquelle hängt, holt eine parametrisierte Abfrage die Zeile aus deinem ERP und füllt das Formular vor - die DHL-Variante kauft auf eine Bestell-ID sogar echtes Porto und druckt die Marke.
Damit ist die Bandbreite komplett: Events stoßen den Druck automatisch an, Print Views geben Menschen unterwegs eine sichere, minimalistische Oberfläche - und beide laufen auf derselben Render-Engine in demselben Container.
Der eigentliche Kern: Deploy per Git-Pipeline
Jetzt zu dem Punkt, der die „Online vs. Desktop vs. lokal"-Frage auf einer ganz anderen Ebene beantwortet: Deployment.
Ein Viewer wird installiert. Eine Druck-Plattform wird deployt - und zwar mit demselben Werkzeug, mit dem deine Entwickler schon heute Code ausliefern: Git.
Der Ablauf ist bewusst so gebaut, dass er jedes Mal gelingt:
1. Push auf einen Branch = Deploy in eine Stage. dev geht auf die Test-Stage (zplcloud_test), main in die Produktion (zplcloud). Die Azure-Pipelines (backend/azure-pipelines-backend.yml, weblink/azure-pipelines-weblink.yml) triggern auf Branch-Push.
2. Docker-Build aus dem Repo - ein Image (Angular-Frontend + ASP.NET-Core-API, Basis aspnet:10 azurelinux3, amd64, rund 260 MB).
3. Blue-Green-Deploy mit Health-Gate: Der neue Container startet ohne Host-Ports, wird per Health-Check (/api/health) verifiziert, und erst wenn er gesund ist, wird der alte entfernt. Schlägt der Check fehl, kommt der Rollback und der alte Container läuft unangetastet weiter. Kein Downtime-Fenster, kein „hoffentlich läuft's".
4. Rollback = letzter grüner Stand. Weil Image-Tag = Build-ID ist, ist der Weg zurück ein einziger docker run mit dem vorherigen Tag - oder ein Re-Run der Pipeline auf dem letzten Commit.
Warum das immer gelingt: Die DB-Migration ist additiv und idempotent (neue Tabellen, neue nullable Spalten, IF NOT EXISTS-Skripte in backend/scripts/*.sql). Das heißt: Die Datenbank kann vor dem Code-Deploy migriert werden, alter und neuer Code laufen beide mit dem neuen Schema. Die Reihenfolge ist immer dieselbe: Backup, Migration, Verifikation, EF-Regenerate, Merge, Deploy, Smoke-Test.
Und weil alles in einem Container steckt, ist die Zielumgebung egal:
- Eigene Cloud / Rechenzentrum: Container auf jedem Docker-Host oder Kubernetes-Cluster laufen lassen.
- On-Prem: Der CLI-Agent (
zplcloud proxy --agent, selbst als Docker-Container verfügbar) baut eine ausgehende Verbindung zur Plattform auf (TeamViewer-Prinzip) - deine Drucker und Broker bleiben hinter der Firewall, es wird keine eingehende Verbindung und kein VPN benötigt. - Weblink-Container: Zebra-Drucker per WebSocket-Relay (mTLS-Client-Zertifikate), TCP 9100 - getrennt deploybar, eigene Pipeline.
Ein System, das du per Git-Pipeline in deiner Umgebung ausrollst, lässt sich per Git-Pipeline auch auditieren, versionieren und wiederholen. Genau das meint „extrem skalierbar": mehr Replicas für mehr Render-Durchsatz, mehr Agenten für mehr Standorte, mehr Stages für mehr Sicherheit.
Kein Treiber, nirgends
Ein Treiber ist die klassische Bruchstelle: Windows-Druckertreiber, Hersteller-DLLs, Betriebssystem-Abhängigkeiten. zplCloud umgeht das komplett, weil ZPL Text ist.
- Der Druckweg ist ein roher TCP-9100-Stream, ein WebSocket oder USB - kein Druckertreiber, keine Hersteller-Software auf dem Client.
- Plattformunabhängig: Der Client ist ein Browser (Angular), die Engine .NET im Linux-Container. Windows, macOS, Linux, Tablet, Raspberry Pi - egal, solange ein Browser oder ein Agent läuft.
- Keine Laufzeit-Abhängigkeit von externen CDNs: Alle Assets (Tailwind-CSS, Fonts, Scanner-WASM) sind self-hosted. Läuft das System hinter einer Firewall ohne Internet, läuft es vollständig.
Das löst das „Offline / restriktive IT"-Szenario nicht durch einen Desktop-Viewer, sondern dadurch, dass die Plattform selbst lokal läuft.
Jeden Workflow abdecken - vom Entwickler bis zum Hersteller
Statt „match the tool type to your constraints" gilt bei zplCloud: eine Plattform, alle Größenordnungen - und der Bogen spannt sich über alle Stufen:
- Entwickler: Designer mit Code-View (C#-Codegen, Roundtrip Design zu Code), API (
/api/zpl,/api/render/*,/api/export/console), CLI (zplcloud send,proxy,firmware). Render-Preview im CI, Deploy per Git - derselbe Ablauf wie jeder andere Service. - Kleines Büro mit Briefmarken: DHL-Internetmarke direkt kaufen und als ZPL auf den Zebra drucken - Absender + Empfänger rein, Portokasse wird belastet, Marke kommt aus dem Drucker. Kein Frankiermaschinen-Zwang.
- Desktop-Drucker / Einzelplatz: USB- oder Netzwerk-Drucker per Agent anbinden, lokal rendern und drucken - ohne Cloud, wenn es sein muss.
- Entrepreneurs / Solo: Ein Design, eine Print View, ein Drucker. Formularbasierte Print Views als mobile PWA - für den täglichen Einzeldruck am Packtisch oder unterwegs.
- Small Business: Team-Accounts, gemeinsame Designs, Datenhub (fünf Datenbanken plus Spreadsheets), Kunden-Arbeitsbereiche (3PL), Rechte über Scope.
- Logistik: Amazon-FBA-Labels aus einer CSV (FNSKU/Karton/Palette), DHL-only-Print-Views mit Bestell-ID-Lookup, Batch-Läufe.
- Manufacturers: ERP-/MES-Events über Kafka, MQTT oder Service Bus direkt auf die Produktionsdrucker - quittiert wird erst nach dem Druck, keine verlorenen Etiketten.
Die Gemeinsamkeit: Es ist immer dieselbe Plattform. Wer klein anfängt, muss beim Skalieren nicht die Tool-Kategorie wechseln - er aktiviert nur die nächste Stufe derselben Pipeline.
Drei Erfolgssignale
Woran erkennt man, dass die Label-Strecke wirklich sitzt? An drei Signalen:
1. Weniger Testdrucke - weil die Vorschau mit der Druck-Engine identisch ist und Fehler vor dem physischen Etikett sichtbar werden.
2. Dev und Ops sprechen über dieselbe Ausgabe - weil das Label als Design-JSON + gerendertes ZPL ein gemeinsamer, versionierbarer Vertrag ist, nicht ein Screenshot.
3. Template-Änderungen überraschen nicht mehr - weil Review wiederholbar ist (gleicher Render, gleiche Engine, gleiche Stage) und ein Deploy per Pipeline ein nachvollziehbarer, rollback-fähiger Schritt ist.
Ein Viewer verhindert Fehler. Eine Pipeline macht den Weg vom Ereignis bis zum Etikett deterministisch - und genau das ist der Unterschied, den diese Einteilung am Ende meint.