



zplCloud Blog
在线查看器、桌面工具还是本地脚本?更好的问题是:你的标签流水线运行在哪里?
当设计、渲染、流式处理和打印都位于同一个容器中——无论是云端、本地部署还是你自己的数据中心,并通过一次 git push 完成部署——“在线 vs 桌面 vs 本地”之争便告终结。
在线、桌面还是本地——问错了问题
每个和 Zebra 标签打交道的人都经历过这样的时刻:标签在代码里看起来没问题,打印出来却偏移、旋转、被截断——或者条码根本扫不出来。常见的应对方式是去问 工具类型:在线查看器追求速度与协作,桌面工具应对离线和受限网络,本地开发脚本则适合贴近代码的开发者。再加上几条标准——安全性、协作、调试速度、IT 限制、处理量——决定就做出来了。
这是一个可行的框架。对查看器而言。
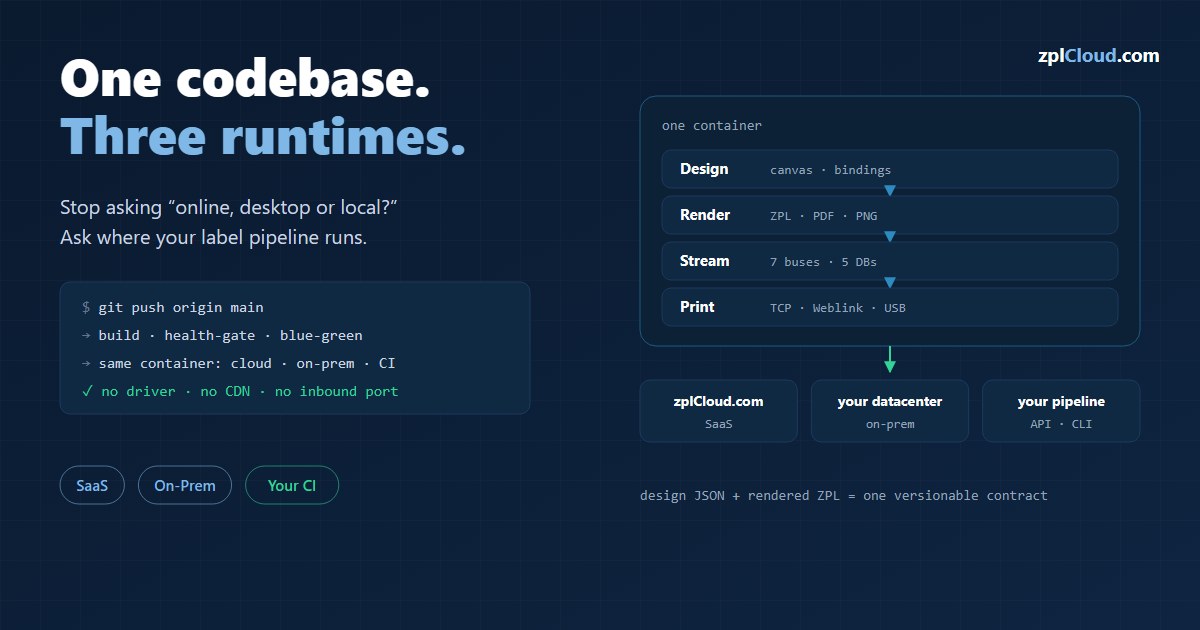
zplCloud 对同一个问题给出了不同的答案。我们不比较“哪个窗口能显示我的标签”,而是问 “从数据事件到实体标签的整条路径在哪里运行?”。于是二选一变成了兼而有之:zplCloud 同时是云端查看器、桌面工具和本地工具——因为设计、渲染、流式处理和打印都位于同一个容器中,你可以在数据和打印机所在的任何地方启动它。问题不再是“哪种工具?”,而是 “我要把流水线部署到哪个环境?”
一张表看懂转变
| 常见的划分 | zplCloud 的答案 |
|---|---|
| 在线 / 云端查看器 | zplCloud.com 作为 SaaS——无需安装,打开浏览器,渲染标签,分享出去 |
| 桌面查看器(离线、受限环境) | 同一个容器本地部署——你的数据中心、你的防火墙、完全掌控 |
| 本地开发工具(贴近代码) | API + CLI + 代码视图——在你自己的 CI 中、通过 git 流水线、curl 或 zplcloud send 进行渲染 |
不是三个产品。一套代码库,三种运行环境。 正因如此,传统的决策逻辑可以被彻底颠倒:问题不再是“哪种工具类型适合我的限制条件?”,而是“我有哪些限制条件——容器又该为此运行在哪台主机上?”。
先渲染,后打印——使用真正的引擎
标签项目中最常见的错误,是把“能渲染”当成“能正确打印”。zplCloud 通过预览与打印使用同一个引擎来弥合这一差距。
- 设计器在自己的后端渲染 PNG/PDF/SVG/ZPL 预览——不依赖外部渲染服务,运行时也不调用外部 CDN(这对我们是一条硬性规定,既出于合规,也出于可用性)。
- 你在预览中看到的,与之后以 ZPL(
^XA…^XZ)形式发送到打印机的内容逐字节一致。203 dpi 的渲染就是 203 dpi 的渲染——条码、二维码、TrueType 字体,全部出自同一来源。 - 引擎被构建为支持批量处理的 API:
POST /api/zpl、/api/render/png、/api/render/pdf、/api/export/console。一个设计加 N 条记录,就是 N 张标签——无需逐张点击。 - 性能是设计原则,而不是一项功能:渲染在容器进程内运行,可水平扩展(副本越多,渲染吞吐量越高),并且可以用随附的 perftest 镜像(
scripts/perftest.sh,模式zpl/pdf/png/zpl-api)针对任意阶段进行测量——上线前做负载测试,而不是上线后祈祷。
这就是对“处理量与回归”问题的回答:以编程方式生成大量标签变体(模板、动态字段、众多 SKU)的人,需要的不是查看器窗口,而是一条可重复的渲染路径——在这里,它是一次 API 调用,而不是一张截图。
用事件代替按钮:数据与事件流
查看器首先是打印前的一道质量关卡。但在真实的物流场景中,打印通常是某个事件的结果:一个订单事件、一项拣货任务、一个来自 MES 的序列号、一行来自 ERP 的数据。
zplCloud 将事件直接变为打印触发器。共有七种消息总线为其提供数据:
- Apache Kafka——订阅一个 topic;每条消息都会用标签设计渲染并发送到打印机。云模式(broker 位于互联网上,例如 Confluent 或 MSK)或本地部署模式(broker 位于你的防火墙之后,由 CLI 代理消费——broker 凭据永远不会离开你的网络)。
- Azure Service Bus、MQTT、AMQP 1.0、RabbitMQ、Amazon SQS 和 Google Pub/Sub——为其他所有环境提供相同的机制。在工厂车间里,MQTT 最为关键,因为秤、扫描器和 PLC 早已接在 broker 上。
- 数据中心数据源——SQL Server、MongoDB、PostgreSQL、MySQL 和 MariaDB。通过 CLI 代理以下推方式查询:查询在本地运行,只有结果传到平台。可访问的云数据库也可以直接连接,完全无需代理。
而这正是大多数流式集成含糊其辞的地方,所以我们说得精确一些:
- 消费者仅在打印成功后才确认。打印失败?Kafka 保持 offset 不变,Service Bus 放弃该消息并在三次投递后将其转入死信队列,MQTT 则干脆不确认,由 broker 以 QoS 1 或 2 重新投递。不会静默跳过,也不会无限重试。
- Broker 错误(无法访问、认证被拒、topic 不存在)不是打印错误,因此会采用指数退避(5 s 到 60 s),其状态在界面中可见。
- 保活机制会将 Link-OS 打印机从待机状态中唤醒,因此暂停后的第一张标签不会因唤醒延迟而变慢。
一张没有打印出来的标签,是一个必须有人看到的物理事实。正是这种语义确保了这一点——这也是查看器与流水线之间的区别。
双向打通,包括存储桶
打印文件往往早已存放在对象存储中:承运商标签、预先渲染的批次、为满足保留规定而存档的文件。因此总线消息根本不必携带 ZPL——它只需指向该文件:
{ "schemaVersion": 1, "printer": "*", "zplRef": { "storage": "archive", "key": "orders/4711.zpl" } }
文件在打印时从 S3 或 Azure Blob 获取。反过来也一样:输出目标会把每张已打印的标签写回存储桶,向七种总线中的任意一种发送消息,并触发带 HMAC 签名的 webhook——每个步骤单独开启,且全部在打印之后执行,因此缓慢的存储桶永远不会拖慢产线。
为车间量身定制的界面:Print View
硬币的另一面:并非每张标签都来自事件。很多时候,有人站在打包台前、在发货区、在仓库里——他们需要的是好用的东西,而不是终端。
Print View 正是为此而生。平台会根据已保存的设计生成一个独立的响应式表单,并配有专属链接:
https://print.zplcloud.com/d/{designKey}/{viewSlug}
这对工作流意味着什么,以及它为何在移动场景下同样好用:
- 移动优先与 PWA: 每个视图都自带
manifest.json和应用图标。在 Android 和 iOS 上通过“添加到主屏幕”,链接就会变成一个直接打开表单的应用图标。无需应用商店、无需安装、无需驱动的应用。 - 是表单,而不是设计器: 带校验的文本字段、来自数据源的下拉框、复选框。操作员填写的是值,而不是 ZPL。只有你标记为可见的字段才能编辑。
- 每个字段旁都有扫描按钮: 点一下相机,就能把条码或二维码直接扫入字段。这决定了 Print View 能否经受住现实的考验——在打包台上用手机手动输入 13 位 EAN 可经受不住。
- 实时预览: PDF 预览会随着输入实时重新渲染,所用的正是生成 ZPL 的同一个服务端引擎。屏幕上显示的,就是打印机输出的。
- 是投影,而不是分享链接: 值在服务端校验,锁定的字段甚至不在 payload 中,设计本身也永远不会到达浏览器。拥有 URL 的人可以打印这一张标签——但无法访问你的账户。
打印可以发送到 Weblink 打印机、CLI 代理上的远程打印机,或以 PDF 形式输出到本地打印对话框。如果视图关联了数据中心数据源,参数化查询会从你的 ERP 中取出对应行并预填表单——DHL 变体甚至能根据订单号购买真实邮资并打印邮票。
这就覆盖了全部场景:事件自动触发打印,Print View 为移动中的人员提供安全、精简的界面——两者都运行在同一容器中的同一渲染引擎上。
真正的关键:通过 git 流水线部署
下面这部分将在一个完全不同的层面上回答“在线 vs 桌面 vs 本地”的问题:部署。
查看器是安装的。打印平台则是部署的——使用你的开发人员早已用来交付代码的同一个工具:git。
整个流程经过刻意设计,确保每次都能成功:
1. 推送到分支即部署到阶段。 dev 部署到测试阶段(zplcloud_test),main 部署到生产环境(zplcloud)。Azure 流水线(backend/azure-pipelines-backend.yml、weblink/azure-pipelines-weblink.yml)在分支推送时触发。
2. 从代码仓库进行 Docker 构建——生成一个镜像(Angular 前端加 ASP.NET Core API,基于 aspnet:10 azurelinux3,amd64,约 260 MB)。
3. 带健康检查关卡的蓝绿部署: 新容器在不绑定主机端口的情况下启动,通过健康检查(/api/health)验证,只有确认健康后才移除旧容器。如果检查失败则回滚,旧容器继续原样运行。没有停机窗口,也无需祈祷好运。
4. 回滚即回到上一个绿色状态。 由于镜像标签就是构建 ID,回退只需用上一个标签执行一次 docker run——或者在上一次提交上重新运行流水线。
为什么它“总能成功”:数据库迁移是增量且幂等的(新表、新的可空列、backend/scripts/*.sql 下的 IF NOT EXISTS 脚本)。因此数据库可以在代码部署之前完成迁移,新旧代码都能在新架构上运行。顺序始终不变:备份、迁移、验证、重新生成 EF、合并、部署、冒烟测试。
而且因为一切都在同一个容器中,目标环境并不重要:
- 你自己的云或数据中心: 在任意 Docker 主机或 Kubernetes 集群上运行容器。
- 本地部署: CLI 代理(
zplcloud proxy --agent,本身也提供 Docker 容器版本)以类似 TeamViewer 的方式向平台建立一条出站连接——你的打印机和 broker 留在防火墙之后,无需入站连接,也无需 VPN。 - Weblink 容器: 通过 WebSocket 中继(mTLS 客户端证书)连接 Zebra 打印机,TCP 9100——可单独部署,并拥有自己的流水线。
通过 git 流水线推送到你的环境中的系统,同样可以通过 git 流水线进行审计、版本管理和重复部署。这才是“可扩展”在这里的真正含义:更多副本带来更高的渲染吞吐量,更多代理覆盖更多站点,更多阶段带来更高的安全性。
任何地方都无需驱动
驱动程序是典型的故障点:Windows 打印机驱动、厂商 DLL、操作系统依赖。zplCloud 完全绕开了这些,因为 ZPL 就是文本。
- 打印路径是原始的 TCP 9100 数据流、WebSocket 或 USB——无需打印机驱动,客户端也无需厂商软件。
- 平台无关: 客户端是浏览器(Angular),引擎是运行在 Linux 容器中的 .NET。Windows、macOS、Linux、平板电脑、Raspberry Pi——都无所谓,只要能运行浏览器或代理即可。
- 运行时不依赖外部 CDN: 所有资源(Tailwind CSS、字体、扫描器 WASM)均为自托管。即使在无法访问互联网的防火墙之后,系统依然能完整运行。
这样解决“离线 / 受限 IT”场景的方式不是桌面查看器,而是在本地运行平台本身。
覆盖所有工作流,从开发者到制造商
zplCloud 不是让你“根据限制条件选择工具类型”,而是提供适用于各种规模的同一个平台——覆盖范围包括:
- 开发者: 带代码视图的设计器(C# 代码生成,设计与代码双向往返)、API(
/api/zpl、/api/render/*、/api/export/console)、CLI(zplcloud send、proxy、firmware)。在 CI 中渲染预览,通过 git 部署——与其他任何服务的流程相同。 - 需要邮票的小型办公室: 直接购买 DHL Internetmarke 邮资,并以 ZPL 形式在 Zebra 上打印。填入寄件人和收件人,从邮资账户扣费,邮票就从打印机里出来了。无需邮资机。
- 桌面打印机 / 单个工作站: 通过代理连接 USB 或网络打印机,在本地渲染和打印——如果有此要求,完全无需云端。
- 创业者和个体经营者: 一个设计、一个 Print View、一台打印机。基于表单的 Print View 以移动 PWA 形式运行,满足工作台前或外出途中每天打印单张标签的需求。
- 小型企业: 团队账户、共享设计、数据中心(五种数据库加电子表格)、面向 3PL 的客户工作区、按范围分配的权限。
- 物流: 从 CSV 生成 Amazon FBA 标签(FNSKU、纸箱、托盘),支持订单号查询的 DHL 专用 Print View,批量运行。
- 制造商: ERP 和 MES 事件经由 Kafka、MQTT 或 Service Bus 直接送到生产打印机——仅在打印后才确认,因此不会丢失任何标签。
贯穿其中的主线是:始终是同一个平台。 从小规模起步并不意味着日后要更换工具类别,而是在同一条流水线上开启下一个阶段。
行之有效的三个信号
如何判断标签路径真正合适?看三个信号:
1. 测试打印更少——因为预览与打印引擎完全一致,错误会在实体标签出现之前就暴露出来。
2. 开发和运维讨论的是同一份输出——因为标签是设计 JSON 加渲染后的 ZPL,是一份共享、可版本化的约定,而不是一张截图。
3. 模板变更不再让人措手不及——因为评审是可重复的(同样的渲染、同样的引擎、同样的阶段),而通过流水线的部署是一个可追溯、可回滚的步骤。
查看器能防止错误。流水线则让从事件到标签的路径变得确定——而这,归根结底,正是整个分类讨论一直想要触及的区别。