



zplCloud Blog
Viewer en ligne, outil de bureau ou script local ? La vraie question : où tourne votre pipeline d'étiquettes ?
Le débat « en ligne, bureau ou local » prend fin dès que conception, rendu, streaming et impression vivent dans un seul conteneur - dans le cloud, on-prem ou dans votre propre datacenter, déployé par un git push.
En ligne, bureau ou local - la mauvaise question
Quiconque travaille avec des étiquettes Zebra connaît ce moment : l'étiquette semble correcte dans le code, puis elle s'imprime décalée, pivotée, tronquée - ou avec un code-barres qui ne se scanne pas. La réponse habituelle est une question sur le type d'outil : un viewer en ligne pour la rapidité et la collaboration, un outil de bureau pour le hors-ligne et les réseaux restrictifs, un script de développement local pour les développeurs qui restent proches du code. Ajoutez quelques critères - sécurité, collaboration, rapidité de débogage, contraintes IT, volume - et la décision est prise.
C'est un cadre qui fonctionne. Pour un viewer.
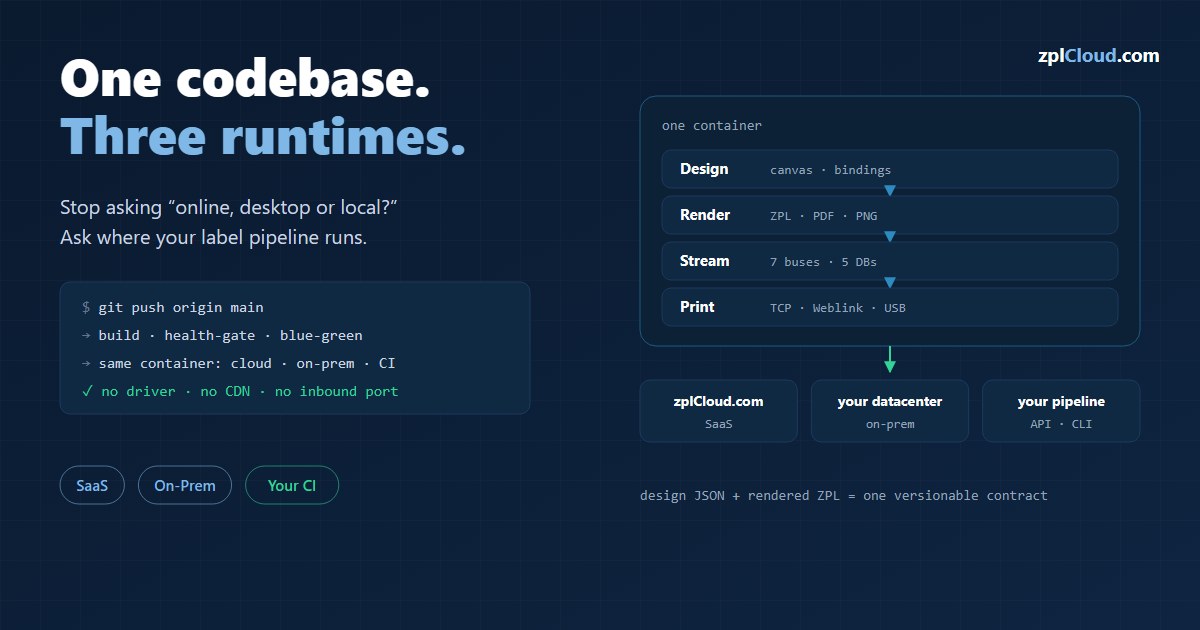
zplCloud répond autrement à la même question. Nous ne comparons pas « quelle fenêtre m'affiche l'étiquette », nous demandons « où s'exécute tout le chemin, de l'événement de données à l'étiquette physique ? ». Et là, le « ou bien » devient un « et » : zplCloud est à la fois un viewer cloud, un outil de bureau et un outil local - parce que conception, rendu, streaming et impression se trouvent dans un seul conteneur, que vous démarrez là où se trouvent vos données et vos imprimantes. La question n'est plus « quel type d'outil ? », mais « dans quel environnement est-ce que je déploie le pipeline ? »
Le changement en un tableau
| La répartition habituelle | La réponse zplCloud |
|---|---|
| Viewer en ligne / cloud | zplCloud.com en SaaS - sans installation, ouvrez un navigateur, rendez une étiquette, partagez-la |
| Viewer de bureau (hors ligne, restrictif) | le même conteneur on-prem - votre datacenter, votre pare-feu, contrôle total |
| Outils de dev locaux (proches du code) | API + CLI + vue code - rendu dans votre propre CI, via un pipeline git, curl ou zplcloud send |
Pas trois produits. Une base de code, trois environnements d'exécution. C'est exactement pour cela que la logique de décision classique peut être renversée : au lieu de « quel type d'outil convient à ma contrainte ? », elle devient « quelle contrainte ai-je - et sur quel hôte le conteneur tourne-t-il pour y répondre ? ».
Rendre d'abord, imprimer ensuite - avec le vrai moteur
L'erreur la plus fréquente dans les projets d'étiquettes consiste à confondre « ça s'affiche » avec « ça s'imprime correctement ». zplCloud comble cet écart en utilisant le même moteur pour l'aperçu et l'impression.
- Le designer rend l'aperçu PNG/PDF/SVG/ZPL dans son propre backend - pas de service de rendu externe, pas d'appel à un CDN externe à l'exécution (pour nous une règle absolue, autant pour la conformité que pour la disponibilité).
- Ce que vous voyez dans l'aperçu est, octet pour octet, ce qui part ensuite vers l'imprimante en ZPL (
^XA…^XZ). Un rendu à 203 dpi est un rendu à 203 dpi - code-barres, QR, police TrueType, tout d'une seule source. - Le moteur est conçu comme une API capable de traiter des lots :
POST /api/zpl,/api/render/png,/api/render/pdf,/api/export/console. Un design plus N enregistrements égale N étiquettes - sans cliquer étiquette par étiquette. - La performance est un principe de conception, pas une fonctionnalité : le rendu s'exécute dans le processus du conteneur, passe à l'échelle horizontalement (plus de réplicas, plus de débit de rendu) et peut être mesuré sur n'importe quel stage avec l'image perftest fournie (
scripts/perftest.sh, modeszpl/pdf/png/zpl-api) - un test de charge avant la mise en production plutôt que de l'espoir après coup.
C'est la réponse à « volume et régression » : qui produit de nombreuses variantes d'étiquettes par programme (modèles, champs dynamiques, nombreux SKU) n'a pas besoin d'une fenêtre de viewer, mais d'un chemin de rendu reproductible - et ici, c'est un appel d'API, pas une capture d'écran.
Des événements plutôt qu'un bouton : streaming de données et d'événements
Un viewer est avant tout un contrôle qualité avant l'impression. Dans la logistique réelle, pourtant, l'impression est généralement la conséquence d'un événement : un événement de commande, une tâche de préparation, un numéro de série venant du MES, une ligne venant de l'ERP.
zplCloud transforme directement l'événement en déclencheur d'impression. Sept bus de messages l'alimentent :
- Apache Kafka - abonnez-vous à un topic ; chaque message est rendu avec un design d'étiquette et envoyé à une imprimante. Mode cloud (broker sur internet, Confluent ou MSK par exemple) ou mode on-prem (broker derrière votre pare-feu, consommé par l'agent CLI - les identifiants du broker ne quittent jamais votre réseau).
- Azure Service Bus, MQTT, AMQP 1.0, RabbitMQ, Amazon SQS et Google Pub/Sub - la même mécanique pour tous les autres environnements. MQTT est celui qui compte dans un atelier de production, où balances, scanners et PLC sont déjà reliés au broker.
- Sources du data hub - SQL Server, MongoDB, PostgreSQL, MySQL et MariaDB. Recherche par pushdown via l'agent CLI : la requête s'exécute on-prem, seul le résultat voyage vers la plateforme. Les bases de données cloud accessibles peuvent aussi être connectées directement, sans aucun agent.
Et voici la partie où la plupart des intégrations de streaming deviennent vagues, alors soyons précis :
- Le consommateur n'acquitte qu'après une impression réussie. L'impression a échoué ? Kafka laisse l'offset là où il était, Service Bus abandonne le message et le place en dead-letter après trois livraisons, MQTT n'acquitte tout simplement pas et le broker relivre en QoS 1 ou 2. Pas de saut silencieux, pas de boucle de réessai infinie.
- Les erreurs de broker (injoignable, authentification refusée, topic disparu) ne sont pas des erreurs d'impression ; elles bénéficient donc d'un backoff exponentiel (de 5 s à 60 s), avec l'état visible dans l'interface.
- Un keepalive sort les imprimantes Link-OS de veille, pour que la première étiquette après une pause ne soit pas ralentie par la latence de réveil.
Une étiquette qui n'a pas été imprimée est un fait physique que quelqu'un doit voir. C'est cette sémantique qui le garantit - et c'est la différence entre un viewer et un pipeline.
Dans les deux sens, bucket compris
Les fichiers d'impression se trouvent souvent déjà dans un stockage objet : étiquettes de transporteurs, lots pré-rendus, archives conservées pour des obligations de conservation. Le message du bus n'a donc pas du tout besoin de transporter le ZPL - il peut simplement y renvoyer :
{ "schemaVersion": 1, "printer": "*", "zplRef": { "storage": "archive", "key": "orders/4711.zpl" } }
Le fichier est récupéré depuis S3 ou Azure Blob au moment de l'impression. Et dans l'autre sens : une cible de sortie réécrit chaque étiquette imprimée dans un bucket, envoie un message vers l'un des sept bus et déclenche un webhook signé HMAC - chaque étape activable séparément, toutes après l'impression, pour qu'un bucket lent ne bloque jamais la ligne.
Une interface sur mesure pour l'atelier : les Print Views
L'autre face de la même médaille : toutes les étiquettes ne proviennent pas d'un événement. Souvent, une personne se tient à la table d'emballage, à l'expédition, dans l'entrepôt - et a besoin de quelque chose d'utilisable, pas d'un terminal.
Une Print View, c'est exactement cela. À partir d'un design enregistré, la plateforme génère un formulaire responsive à part entière, avec son propre lien :
https://print.zplcloud.com/d/{designKey}/{viewSlug}
Ce que cela signifie pour le flux de travail, et pourquoi cela fonctionne en mobilité :
- Mobile-first et PWA : chaque vue fournit son propre
manifest.jsonet son icône d'app. « Ajouter à l'écran d'accueil » transforme le lien en icône d'app sur Android et iOS, qui ouvre directement le formulaire. Une app sans app store, sans installation, sans driver. - Un formulaire, pas un designer : champs texte avec validation, listes déroulantes alimentées par une source de données, cases à cocher. L'opérateur saisit des valeurs, pas du ZPL. Seuls les champs que vous avez marqués visibles sont modifiables.
- Un bouton scanner à côté de chaque champ : touchez la caméra, scannez un code-barres ou un QR directement dans le champ. C'est ce qui décide si une Print View survit au contact avec la réalité - saisir un EAN de 13 chiffres sur un téléphone à la table d'emballage, non.
- Aperçu en direct : un aperçu PDF se re-rend pendant la saisie, avec le même moteur côté serveur qui produit le ZPL. Ce qui est à l'écran est ce qui sort de l'imprimante.
- Une projection, pas un lien de partage : les valeurs sont validées côté serveur, les champs verrouillés ne figurent même pas dans le payload, et le design lui-même n'atteint jamais le navigateur. Qui possède l'URL peut imprimer cette étiquette-là - sans pouvoir accéder à votre compte.
L'impression part vers une imprimante Weblink, une imprimante distante sur l'agent CLI, ou vers un PDF dans la boîte de dialogue d'impression locale. Et quand la vue est adossée à une source du data hub, une requête paramétrée tire la ligne de votre ERP et pré-remplit le formulaire - la variante DHL achète même un vrai affranchissement à partir d'un numéro de commande et imprime le timbre.
Cela couvre tout l'éventail : les événements déclenchent l'impression automatiquement, les Print Views donnent aux personnes en déplacement une interface sûre et minimale - et les deux tournent sur le même moteur de rendu, dans le même conteneur.
Le vrai sujet : déployer via un pipeline git
Venons-en à la partie qui répond à la question « en ligne, bureau ou local » à un tout autre niveau : le déploiement.
Un viewer, on l'installe. Une plateforme d'impression, on la déploie - avec l'outil que vos développeurs utilisent déjà pour livrer du code : git.
La séquence est délibérément conçue pour réussir à chaque fois :
1. Un push sur une branche égale un déploiement sur un stage. dev va sur le stage de test (zplcloud_test), main en production (zplcloud). Les pipelines Azure (backend/azure-pipelines-backend.yml, weblink/azure-pipelines-weblink.yml) se déclenchent au push sur la branche.
2. Build Docker depuis le dépôt - une seule image (frontend Angular plus API ASP.NET Core, basée sur aspnet:10 azurelinux3, amd64, environ 260 Mo).
3. Déploiement blue-green avec contrôle de santé : le nouveau conteneur démarre sans ports hôte, est vérifié par un health check (/api/health), et ce n'est qu'une fois sain que l'ancien est supprimé. Si le contrôle échoue, rollback, et l'ancien conteneur continue de tourner sans être touché. Pas de fenêtre d'interruption, pas besoin de croiser les doigts.
4. Rollback égale le dernier état vert. Comme le tag de l'image est l'id du build, revenir en arrière se résume à un seul docker run avec le tag précédent - ou à relancer le pipeline sur le dernier commit.
Pourquoi cela « réussit toujours » : la migration de base de données est additive et idempotente (nouvelles tables, nouvelles colonnes nullables, scripts IF NOT EXISTS sous backend/scripts/*.sql). La base peut donc être migrée avant le déploiement du code, et l'ancien comme le nouveau code tournent sur le nouveau schéma. L'ordre est toujours le même : sauvegarde, migration, vérification, régénération EF, merge, déploiement, smoke test.
Et comme tout se trouve dans un seul conteneur, l'environnement cible n'a pas d'importance :
- Votre propre cloud ou datacenter : exécutez le conteneur sur n'importe quel hôte Docker ou cluster Kubernetes.
- On-prem : l'agent CLI (
zplcloud proxy --agent, lui-même disponible en conteneur Docker) ouvre une connexion sortante vers la plateforme, à la manière de TeamViewer - vos imprimantes et brokers restent derrière le pare-feu, aucune connexion entrante et aucun VPN nécessaires. - Conteneur Weblink : imprimantes Zebra via un relais WebSocket (certificats clients mTLS), TCP 9100 - déployable séparément, avec son propre pipeline.
Un système que vous déployez dans votre environnement via un pipeline git peut aussi être audité, versionné et reproduit via un pipeline git. C'est ce que « passer à l'échelle » signifie vraiment ici : plus de réplicas pour plus de débit de rendu, plus d'agents pour plus de sites, plus de stages pour plus de sécurité.
Aucun driver, nulle part
Le driver est le point de rupture classique : drivers d'impression Windows, DLL de fabricants, dépendances au système d'exploitation. zplCloud contourne tout cela, parce que le ZPL, c'est du texte.
- Le chemin d'impression est un flux TCP 9100 brut, un WebSocket ou de l'USB - aucun driver d'imprimante, aucun logiciel fabricant sur le client.
- Indépendant de la plateforme : le client est un navigateur (Angular), le moteur est du .NET dans un conteneur Linux. Windows, macOS, Linux, tablette, Raspberry Pi - peu importe, du moment qu'un navigateur ou un agent tourne.
- Aucune dépendance d'exécution à des CDN externes : chaque ressource (Tailwind CSS, polices, WASM du scanner) est auto-hébergée. Derrière un pare-feu sans internet, le système fonctionne toujours entièrement.
Cela résout le scénario « hors ligne / IT restrictive » non pas avec un viewer de bureau, mais en faisant tourner la plateforme elle-même en local.
Couvrir chaque flux de travail, du développeur au fabricant
Au lieu de « faire correspondre le type d'outil à vos contraintes », zplCloud propose une plateforme pour toutes les tailles - et l'éventail les couvre toutes :
- Développeurs : designer avec vue code (génération de code C#, aller-retour entre design et code), API (
/api/zpl,/api/render/*,/api/export/console), CLI (zplcloud send,proxy,firmware). Aperçu de rendu dans la CI, déploiement via git - le même flux que pour n'importe quel autre service. - Un petit bureau avec des timbres : achetez l'affranchissement DHL Internetmarke directement et imprimez-le en ZPL sur la Zebra. Expéditeur et destinataire saisis, le compte d'affranchissement est débité, le timbre sort de l'imprimante. Pas besoin de machine à affranchir.
- Imprimante de bureau / poste de travail unique : connectez une imprimante USB ou réseau via l'agent, rendez et imprimez en local - sans le cloud, si c'est l'exigence.
- Entrepreneurs et indépendants : un design, une Print View, une imprimante. Des Print Views à base de formulaire en PWA mobile, pour l'étiquette unique du quotidien à l'établi ou sur la route.
- Petites entreprises : comptes d'équipe, designs partagés, le data hub (cinq bases de données plus des feuilles de calcul), espaces de travail clients pour les 3PL, permissions par périmètre.
- Logistique : étiquettes Amazon FBA depuis un CSV (FNSKU, carton, palette), Print Views dédiées DHL avec recherche par numéro de commande, exécutions par lots.
- Fabricants : événements ERP et MES via Kafka, MQTT ou Service Bus directement sur les imprimantes de production - acquittés uniquement après l'impression, donc aucune étiquette ne se perd.
Le fil conducteur : c'est toujours la même plateforme. Commencer petit ne signifie pas changer de catégorie d'outil plus tard ; cela signifie activer l'étape suivante du même pipeline.
Trois signes que ça fonctionne
Comment savoir si le chemin des étiquettes convient vraiment ? Trois signaux :
1. Moins d'impressions de test - parce que l'aperçu est identique au moteur d'impression et que les erreurs apparaissent avant l'étiquette physique.
2. Dev et ops parlent du même résultat - parce que l'étiquette est un JSON de design plus du ZPL rendu, un contrat partagé et versionnable plutôt qu'une capture d'écran.
3. Les modifications de modèles ne surprennent plus personne - parce que la revue est reproductible (même rendu, même moteur, même stage) et qu'un déploiement via le pipeline est une étape traçable et réversible par rollback.
Un viewer évite les erreurs. Un pipeline rend le chemin de l'événement à l'étiquette déterministe - et c'est, au fond, la différence que toute cette catégorisation cherchait à saisir.