



zplCloud Blog
ऑनलाइन व्यूअर, डेस्कटॉप टूल या लोकल स्क्रिप्ट? बेहतर सवाल: आपकी लेबल पाइपलाइन कहाँ चलती है?
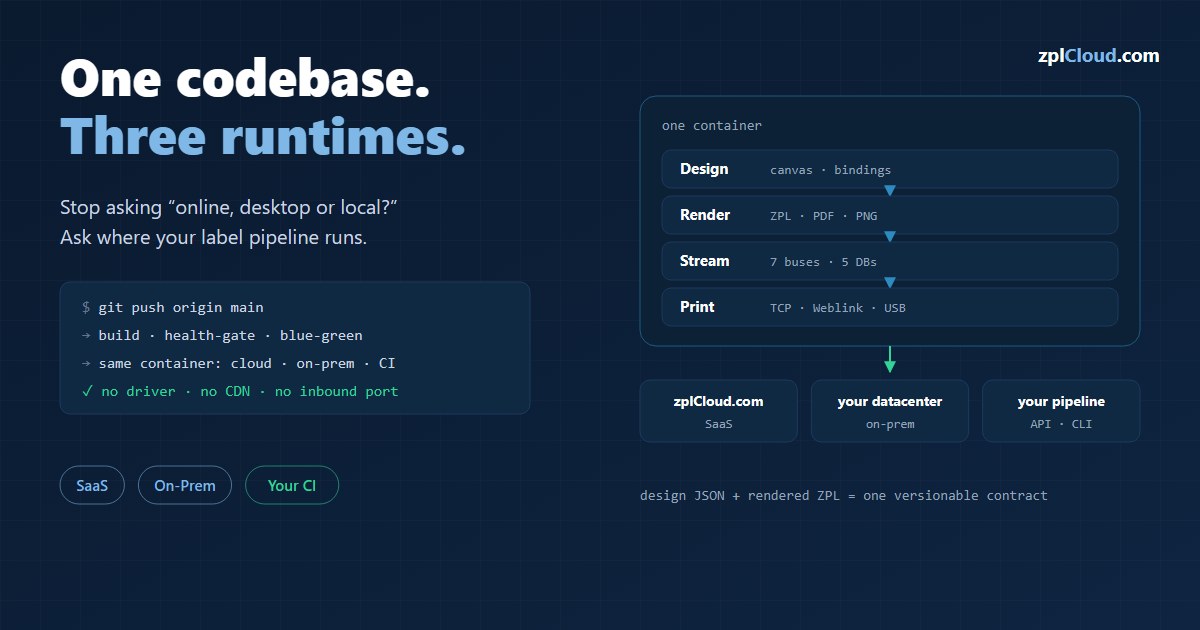
"ऑनलाइन बनाम डेस्कटॉप बनाम लोकल" की बहस तब खत्म हो जाती है जब डिज़ाइन, रेंडरिंग, स्ट्रीमिंग और प्रिंट एक ही कंटेनर में हों - क्लाउड, ऑन-प्रिम या आपके अपने डेटा सेंटर में, एक git push से डिप्लॉय।
ऑनलाइन, डेस्कटॉप या लोकल - गलत सवाल
Zebra लेबल के साथ काम करने वाला हर व्यक्ति इस पल को जानता है: कोड में लेबल सही दिखता है, फिर प्रिंट होकर खिसका हुआ, घूमा हुआ, कटा हुआ निकलता है - या ऐसे बारकोड के साथ जो स्कैन नहीं होता। आमतौर पर इसका जवाब टूल के प्रकार के सवाल में खोजा जाता है: गति और सहयोग के लिए ऑनलाइन व्यूअर, ऑफ़लाइन और प्रतिबंधित नेटवर्क के लिए डेस्कटॉप टूल, कोड के करीब रहने वाले डेवलपर्स के लिए लोकल डेव स्क्रिप्ट। कुछ मानदंड जोड़ें - सुरक्षा, सहयोग, डीबगिंग की गति, IT प्रतिबंध, वॉल्यूम - और फ़ैसला हो जाता है।
यह एक व्यावहारिक ढाँचा है। एक व्यूअर के लिए।
zplCloud इसी सवाल का जवाब अलग तरह से देता है। हम यह तुलना नहीं करते कि "कौन-सी विंडो मुझे लेबल दिखाती है", हम पूछते हैं "डेटा इवेंट से भौतिक लेबल तक का पूरा रास्ता कहाँ चलता है?"। और वहाँ "या तो-या" एक "और" बन जाता है: zplCloud एक साथ क्लाउड व्यूअर, डेस्कटॉप टूल और लोकल टूल है - क्योंकि डिज़ाइन, रेंडरिंग, स्ट्रीमिंग और प्रिंट एक ही कंटेनर में हैं, जिसे आप वहीं शुरू करते हैं जहाँ आपका डेटा और आपके प्रिंटर हैं। सवाल अब यह नहीं है कि "किस तरह का टूल?", बल्कि यह है कि "मैं पाइपलाइन को किस वातावरण में डिप्लॉय करूँ?"
एक तालिका में बदलाव
| सामान्य विभाजन | zplCloud का जवाब |
|---|---|
| ऑनलाइन / क्लाउड व्यूअर | SaaS के रूप में zplCloud.com - कोई इंस्टॉलेशन नहीं, ब्राउज़र खोलें, लेबल रेंडर करें, साझा करें |
| डेस्कटॉप व्यूअर (ऑफ़लाइन, प्रतिबंधित) | वही कंटेनर ऑन-प्रिम - आपका डेटा सेंटर, आपका फ़ायरवॉल, पूरा नियंत्रण |
| लोकल डेव टूल (कोड के करीब) | API + CLI + कोड व्यू - अपने CI में, git पाइपलाइन के ज़रिए, curl या zplcloud send से रेंडर करें |
तीन उत्पाद नहीं। एक कोडबेस, तीन रनटाइम। ठीक इसी वजह से पारंपरिक निर्णय-तर्क को उलटा जा सकता है: "कौन-सा टूल प्रकार मेरी बाधा के अनुकूल है?" के बजाय सवाल बनता है "मेरी बाधा क्या है - और उसके लिए कंटेनर किस होस्ट पर चलता है?"।
पहले रेंडर, फिर प्रिंट - असली इंजन के साथ
लेबल प्रोजेक्ट्स में सबसे आम गलती है "रेंडर हो रहा है" को "सही प्रिंट हो रहा है" मान लेना। zplCloud इस अंतर को पूर्वावलोकन और प्रिंट के लिए एक ही इंजन का उपयोग करके पाटता है।
- डिज़ाइनर PNG/PDF/SVG/ZPL पूर्वावलोकन अपने ही बैकएंड में रेंडर करता है - कोई बाहरी रेंडर सेवा नहीं, रनटाइम पर किसी बाहरी CDN को कोई कॉल नहीं (हमारे लिए यह अनुपालन और उपलब्धता, दोनों के लिए एक सख्त नियम है)।
- पूर्वावलोकन में आप जो देखते हैं, वह बाइट-दर-बाइट वही है जो बाद में ZPL (
^XA…^XZ) के रूप में प्रिंटर तक जाता है। 203 dpi रेंडर 203 dpi रेंडर ही है - बारकोड, QR, TrueType फ़ॉन्ट, सब एक ही स्रोत से। - इंजन एक बैच-सक्षम API के रूप में बना है:
POST /api/zpl,/api/render/png,/api/render/pdf,/api/export/console। एक डिज़ाइन और N रिकॉर्ड का मतलब N लेबल - हर लेबल के लिए अलग क्लिक नहीं। - प्रदर्शन एक डिज़ाइन सिद्धांत है, कोई फ़ीचर नहीं: रेंडरिंग कंटेनर प्रक्रिया के अंदर चलती है, क्षैतिज रूप से स्केल होती है (ज़्यादा रेप्लिका, ज़्यादा रेंडर थ्रूपुट) और साथ आने वाली perftest इमेज (
scripts/perftest.sh, मोडzpl/pdf/png/zpl-api) से किसी भी स्टेज पर मापी जा सकती है - बाद में उम्मीद लगाने के बजाय गो-लाइव से पहले लोड टेस्ट।
यही "वॉल्यूम और रिग्रेशन" का जवाब है: जो कोई प्रोग्राम के ज़रिए बहुत सारे लेबल वेरिएंट बनाता है (टेम्पलेट, डायनेमिक फ़ील्ड, कई SKU), उसे व्यूअर विंडो की ज़रूरत नहीं, उसे एक दोहराने योग्य रेंडर पथ चाहिए - और यहाँ वह एक API कॉल है, स्क्रीनशॉट नहीं।
बटन के बजाय इवेंट: डेटा और इवेंट स्ट्रीमिंग
व्यूअर सबसे पहले प्रिंट से पहले का एक गुणवत्ता द्वार है। लेकिन असली लॉजिस्टिक्स में प्रिंटिंग आमतौर पर किसी इवेंट का परिणाम होती है: एक ऑर्डर इवेंट, एक पिकिंग टास्क, MES से एक सीरियल नंबर, ERP से एक पंक्ति।
zplCloud इवेंट को सीधे प्रिंट ट्रिगर में बदल देता है। सात मैसेज बस इसे डेटा देती हैं:
- Apache Kafka - एक topic सब्सक्राइब करें; हर संदेश एक लेबल डिज़ाइन के साथ रेंडर होकर प्रिंटर को भेजा जाता है। क्लाउड मोड (इंटरनेट पर ब्रोकर, जैसे Confluent या MSK) या ऑन-प्रिम मोड (आपके फ़ायरवॉल के पीछे ब्रोकर, जिसे CLI एजेंट खपाता है - ब्रोकर क्रेडेंशियल्स आपके नेटवर्क से कभी बाहर नहीं जाते)।
- Azure Service Bus, MQTT, AMQP 1.0, RabbitMQ, Amazon SQS और Google Pub/Sub - हर दूसरे वातावरण के लिए वही तंत्र। फ़ैक्टरी फ़्लोर पर MQTT सबसे अहम है, जहाँ तराज़ू, स्कैनर और PLC पहले से ब्रोकर से जुड़े होते हैं।
- डेटा हब स्रोत - SQL Server, MongoDB, PostgreSQL, MySQL और MariaDB। CLI एजेंट के ज़रिए पुशडाउन से लुकअप: क्वेरी ऑन-प्रिम चलती है, केवल परिणाम प्लेटफ़ॉर्म तक जाता है। पहुँच योग्य क्लाउड डेटाबेस बिना किसी एजेंट के सीधे भी जोड़े जा सकते हैं।
और यही वह हिस्सा है जहाँ ज़्यादातर स्ट्रीमिंग इंटीग्रेशन अस्पष्ट हो जाते हैं, इसलिए हम सटीक रहेंगे:
- उपभोक्ता केवल सफल प्रिंट के बाद स्वीकृति (ack) देता है। प्रिंट विफल हुआ? Kafka ऑफ़सेट को वहीं छोड़ देता है, Service Bus संदेश को छोड़ देता है (abandon) और तीन डिलीवरी के बाद उसे dead-letter कतार में डाल देता है, MQTT बस ack नहीं करता और ब्रोकर QoS 1 या 2 पर उसे फिर से डिलीवर करता है। न चुपचाप छोड़ना, न अंतहीन रीट्राई लूप।
- ब्रोकर त्रुटियाँ (अप्राप्य, प्रमाणीकरण अस्वीकृत, topic गायब) प्रिंट त्रुटियाँ नहीं हैं, इसलिए उन पर घातीय बैकऑफ़ (5 s से 60 s) लागू होता है, और स्थिति UI में दिखाई देती है।
- एक कीपालिव Link-OS प्रिंटरों को स्टैंडबाय से जगाता है, ताकि विराम के बाद पहला लेबल वेक-अप विलंब से धीमा न हो।
जो लेबल प्रिंट नहीं हुआ, वह एक भौतिक तथ्य है जिसे किसी को देखना ही होगा। यही सेमेंटिक्स इसे सुनिश्चित करता है - और यही एक व्यूअर और एक पाइपलाइन के बीच का अंतर है।
दोनों दिशाएँ, बकेट सहित
प्रिंट फ़ाइलें अक्सर पहले से ऑब्जेक्ट स्टोरेज में होती हैं: कैरियर लेबल, पहले से रेंडर किए गए बैच, रिटेंशन नियमों के लिए रखे गए आर्काइव। इसलिए बस संदेश को ZPL साथ ले जाने की ज़रूरत ही नहीं - वह उसकी ओर इशारा कर सकता है:
{ "schemaVersion": 1, "printer": "*", "zplRef": { "storage": "archive", "key": "orders/4711.zpl" } }
फ़ाइल प्रिंट के समय S3 या Azure Blob से ली जाती है। और उल्टी दिशा में: एक आउटपुट लक्ष्य हर छपे लेबल को वापस एक बकेट में लिखता है, सात में से किसी भी बस पर संदेश भेजता है और HMAC-हस्ताक्षरित वेबहुक चलाता है - हर चरण अलग से चालू होता है, सभी प्रिंट के बाद, ताकि धीमा बकेट कभी लाइन को न रोके।
शॉप फ़्लोर के लिए कस्टम इंटरफ़ेस: Print Views
उसी सिक्के का दूसरा पहलू: हर लेबल किसी इवेंट से नहीं आता। अक्सर कोई व्यक्ति पैकिंग टेबल पर, शिपिंग में, गोदाम में खड़ा होता है - और उसे कुछ उपयोगी चाहिए, टर्मिनल नहीं।
Print View ठीक यही है। सहेजे गए डिज़ाइन से प्लेटफ़ॉर्म अपने लिंक के साथ एक अलग उत्तरदायी फ़ॉर्म बनाता है:
https://print.zplcloud.com/d/{designKey}/{viewSlug}
वर्कफ़्लो के लिए इसका क्या अर्थ है, और यह चलते-फिरते क्यों काम करता है:
- मोबाइल-फ़र्स्ट और PWA: हर व्यू अपना
manifest.jsonऔर ऐप आइकन साथ लाता है। "होम स्क्रीन में जोड़ें" से लिंक Android और iOS पर एक ऐप आइकन बन जाता है जो सीधे फ़ॉर्म में खुलता है। ऐप स्टोर के बिना, इंस्टॉलेशन के बिना, ड्राइवर के बिना एक ऐप। - फ़ॉर्म, डिज़ाइनर नहीं: सत्यापन वाले टेक्स्ट फ़ील्ड, डेटा स्रोत से ड्रॉपडाउन, चेकबॉक्स। ऑपरेटर मान भरता है, ZPL नहीं। केवल वे फ़ील्ड संपादित किए जा सकते हैं जिन्हें आपने दृश्यमान चिह्नित किया है।
- हर फ़ील्ड के बगल में स्कैनर बटन: कैमरा दबाएँ, बारकोड या QR सीधे फ़ील्ड में स्कैन करें। यही तय करता है कि Print View वास्तविकता के संपर्क में टिकता है या नहीं - पैकिंग टेबल पर फ़ोन में 13-अंकीय EAN टाइप करना नहीं टिकता।
- लाइव पूर्वावलोकन: टाइप करते समय PDF पूर्वावलोकन फिर से रेंडर होता है, उसी सर्वर-साइड इंजन से जो ZPL बनाता है। स्क्रीन पर जो है, वही प्रिंटर से निकलता है।
- प्रक्षेपण, साझा लिंक नहीं: मान सर्वर-साइड सत्यापित होते हैं, लॉक किए गए फ़ील्ड पेलोड में होते ही नहीं, और डिज़ाइन स्वयं कभी ब्राउज़र तक नहीं पहुँचता। जिसके पास URL है, वह यह एक लेबल प्रिंट कर सकता है - आपके खाते तक नहीं पहुँच सकता।
प्रिंटिंग Weblink प्रिंटर, CLI एजेंट पर रिमोट प्रिंटर, या स्थानीय प्रिंट डायलॉग में PDF पर जाती है। और जब व्यू किसी डेटा हब स्रोत से जुड़ा हो, तो एक पैरामीट्रीकृत क्वेरी आपके ERP से पंक्ति निकालकर फ़ॉर्म पहले से भर देती है - DHL संस्करण तो ऑर्डर ID के आधार पर असली पोस्टेज भी खरीदता है और स्टैम्प प्रिंट करता है।
इससे पूरी रेंज कवर होती है: इवेंट प्रिंटिंग को स्वचालित रूप से ट्रिगर करते हैं, Print Views चलते-फिरते लोगों को एक सुरक्षित, न्यूनतम इंटरफ़ेस देते हैं - और दोनों एक ही कंटेनर में एक ही रेंडर इंजन पर चलते हैं।
असली बात: git पाइपलाइन के ज़रिए डिप्लॉय
अब उस हिस्से पर आते हैं जो "ऑनलाइन बनाम डेस्कटॉप बनाम लोकल" सवाल का जवाब बिल्कुल अलग स्तर पर देता है: डिप्लॉयमेंट।
व्यूअर को आप इंस्टॉल करते हैं। प्रिंट प्लेटफ़ॉर्म को आप डिप्लॉय करते हैं - उसी टूल से जिससे आपके डेवलपर्स पहले से कोड शिप करते हैं: git।
क्रम जानबूझकर ऐसा बनाया गया है कि यह हर बार सफल हो:
1. ब्रांच पर push यानी स्टेज पर डिप्लॉय। dev टेस्ट स्टेज (zplcloud_test) पर जाता है, main प्रोडक्शन (zplcloud) पर। Azure पाइपलाइन (backend/azure-pipelines-backend.yml, weblink/azure-pipelines-weblink.yml) ब्रांच push पर ट्रिगर होती हैं।
2. रिपॉज़िटरी से Docker build - एक इमेज (Angular फ़्रंटएंड और ASP.NET Core API, aspnet:10 azurelinux3 पर आधारित, amd64, लगभग 260 MB)।
3. हेल्थ गेट के साथ ब्लू-ग्रीन डिप्लॉय: नया कंटेनर होस्ट पोर्ट के बिना शुरू होता है, हेल्थ चेक (/api/health) से सत्यापित होता है, और केवल स्वस्थ होने के बाद ही पुराना हटाया जाता है। चेक विफल होने पर रोलबैक होता है, और पुराना कंटेनर बिना छुए चलता रहता है। न डाउनटाइम विंडो, न किस्मत का भरोसा।
4. रोलबैक यानी पिछली हरी स्थिति। क्योंकि इमेज टैग ही बिल्ड id है, वापस जाना पिछले टैग के साथ एक docker run भर है - या पिछली कमिट पर पाइपलाइन को फिर से चलाना।
यह "हमेशा सफल" क्यों होता है: डेटाबेस माइग्रेशन योगात्मक और idempotent है (नई तालिकाएँ, नए nullable कॉलम, backend/scripts/*.sql के अंतर्गत IF NOT EXISTS स्क्रिप्ट)। इसलिए डेटाबेस को कोड डिप्लॉय से पहले माइग्रेट किया जा सकता है, और पुराना व नया दोनों कोड नए स्कीमा पर चलते हैं। क्रम हमेशा एक ही रहता है: बैकअप, माइग्रेट, सत्यापन, EF पुनः जनरेट, मर्ज, डिप्लॉय, स्मोक टेस्ट।
और क्योंकि सब कुछ एक कंटेनर में है, लक्ष्य वातावरण मायने नहीं रखता:
- आपका अपना क्लाउड या डेटा सेंटर: कंटेनर को किसी भी Docker होस्ट या Kubernetes क्लस्टर पर चलाएँ।
- ऑन-प्रिम: CLI एजेंट (
zplcloud proxy --agent, जो स्वयं भी Docker कंटेनर के रूप में उपलब्ध है) TeamViewer की तरह प्लेटफ़ॉर्म से एक आउटबाउंड कनेक्शन खोलता है - आपके प्रिंटर और ब्रोकर फ़ायरवॉल के पीछे रहते हैं, कोई इनबाउंड कनेक्शन नहीं और कोई VPN नहीं चाहिए। - Weblink कंटेनर: WebSocket रिले (mTLS क्लाइंट प्रमाणपत्र) पर Zebra प्रिंटर, TCP 9100 - अलग से डिप्लॉय योग्य, अपनी पाइपलाइन के साथ।
जिस सिस्टम को आप git पाइपलाइन के ज़रिए अपने वातावरण में रोल आउट करते हैं, उसे git पाइपलाइन के ज़रिए ऑडिट, वर्ज़न और दोहराया भी जा सकता है। यहाँ "स्केल करना" का असली अर्थ यही है: ज़्यादा रेंडर थ्रूपुट के लिए ज़्यादा रेप्लिका, ज़्यादा साइटों के लिए ज़्यादा एजेंट, ज़्यादा सुरक्षा के लिए ज़्यादा स्टेज।
कहीं भी कोई ड्राइवर नहीं
ड्राइवर पारंपरिक रूप से टूटने का बिंदु है: Windows प्रिंटर ड्राइवर, विक्रेता DLL, ऑपरेटिंग सिस्टम पर निर्भरताएँ। zplCloud इन सबसे बचता है, क्योंकि ZPL टेक्स्ट है।
- प्रिंट पथ एक raw TCP 9100 स्ट्रीम, WebSocket या USB है - कोई प्रिंटर ड्राइवर नहीं, क्लाइंट पर कोई विक्रेता सॉफ़्टवेयर नहीं।
- प्लेटफ़ॉर्म स्वतंत्र: क्लाइंट एक ब्राउज़र (Angular) है, इंजन Linux कंटेनर में .NET है। Windows, macOS, Linux, टैबलेट, Raspberry Pi - कोई फ़र्क नहीं पड़ता, जब तक ब्राउज़र या एजेंट चलता है।
- बाहरी CDN पर कोई रनटाइम निर्भरता नहीं: हर एसेट (Tailwind CSS, फ़ॉन्ट, स्कैनर WASM) सेल्फ़-होस्टेड है। इंटरनेट के बिना फ़ायरवॉल के पीछे भी सिस्टम पूरी तरह चलता है।
इस तरह "ऑफ़लाइन / प्रतिबंधित IT" परिदृश्य डेस्कटॉप व्यूअर से नहीं, बल्कि प्लेटफ़ॉर्म को ही लोकल रूप से चलाकर हल होता है।
डेवलपर से निर्माता तक, हर वर्कफ़्लो कवर
"टूल प्रकार को अपनी बाधाओं से मिलाएँ" के बजाय zplCloud हर आकार के लिए एक प्लेटफ़ॉर्म देता है - और यह दायरा सभी तक फैला है:
- डेवलपर्स: कोड व्यू वाला डिज़ाइनर (C# कोड जनरेशन, डिज़ाइन से कोड तक राउंड ट्रिप), API (
/api/zpl,/api/render/*,/api/export/console), CLI (zplcloud send,proxy,firmware)। CI में रेंडर पूर्वावलोकन, git के ज़रिए डिप्लॉय - किसी भी दूसरी सेवा जैसा ही प्रवाह। - स्टैम्प वाला छोटा ऑफ़िस: DHL Internetmarke पोस्टेज सीधे खरीदें और Zebra पर ZPL के रूप में प्रिंट करें। प्रेषक और प्राप्तकर्ता दर्ज करें, पोस्टेज खाते से राशि कटती है, स्टैम्प प्रिंटर से निकलता है। फ़्रैंकिंग मशीन की ज़रूरत नहीं।
- डेस्कटॉप प्रिंटर / एकल वर्कस्टेशन: एजेंट के ज़रिए USB या नेटवर्क प्रिंटर जोड़ें, लोकल रूप से रेंडर और प्रिंट करें - अगर यही आवश्यकता है तो क्लाउड के बिना।
- उद्यमी और एकल कारोबारी: एक डिज़ाइन, एक Print View, एक प्रिंटर। मोबाइल PWA के रूप में फ़ॉर्म-आधारित Print Views, टेबल पर या रास्ते में रोज़ के एकल लेबल के लिए।
- छोटा व्यवसाय: टीम खाते, साझा डिज़ाइन, डेटा हब (पाँच डेटाबेस और स्प्रेडशीट), 3PL के लिए क्लाइंट वर्कस्पेस, स्कोप के अनुसार अनुमतियाँ।
- लॉजिस्टिक्स: CSV से Amazon FBA लेबल (FNSKU, कार्टन, पैलेट), ऑर्डर id लुकअप वाले केवल-DHL Print Views, बैच रन।
- निर्माता: Kafka, MQTT या Service Bus पर ERP और MES इवेंट सीधे प्रोडक्शन प्रिंटरों तक - केवल प्रिंट के बाद स्वीकृत, इसलिए कोई लेबल गायब नहीं होता।
साझा सूत्र: यह हमेशा वही प्लेटफ़ॉर्म है। छोटे से शुरू करने का मतलब बाद में टूल की श्रेणी बदलना नहीं है; इसका मतलब उसी पाइपलाइन का अगला चरण चालू करना है।
तीन संकेत कि यह काम कर रहा है
कैसे पता करें कि लेबल पथ सचमुच सही बैठता है? तीन संकेत:
1. कम टेस्ट प्रिंट - क्योंकि पूर्वावलोकन प्रिंट इंजन के समान है और त्रुटियाँ भौतिक लेबल से पहले दिख जाती हैं।
2. डेव और ऑप्स एक ही आउटपुट की बात करते हैं - क्योंकि लेबल एक डिज़ाइन JSON और रेंडर किया गया ZPL है, स्क्रीनशॉट के बजाय एक साझा, वर्ज़न योग्य अनुबंध।
3. टेम्पलेट बदलाव लोगों को चौंकाना बंद कर देते हैं - क्योंकि समीक्षा दोहराने योग्य है (वही रेंडर, वही इंजन, वही स्टेज) और पाइपलाइन के ज़रिए डिप्लॉय एक ट्रेस करने योग्य, रोलबैक-सक्षम कदम है।
व्यूअर गलतियों को रोकता है। पाइपलाइन इवेंट से लेबल तक के रास्ते को नियतात्मक बनाती है - और अंततः यही वह अंतर है जिसे यह पूरा वर्गीकरण पकड़ने की कोशिश कर रहा था।