



zplCloud Blog
¿Visor online, herramienta de escritorio o script local? La mejor pregunta: ¿dónde se ejecuta tu pipeline de etiquetas?
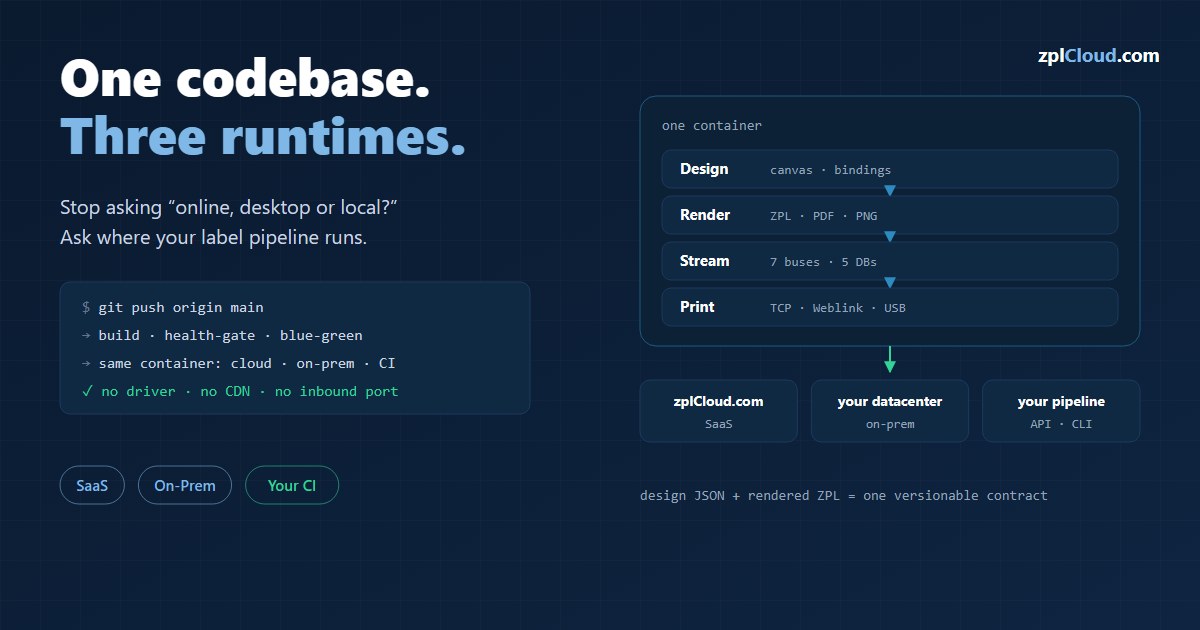
El debate «online vs. escritorio vs. local» termina cuando el diseño, el renderizado, el streaming y la impresión viven en un solo contenedor - en la nube, on-prem o en tu propio centro de datos, desplegado con un git push.
Online, escritorio o local: la pregunta equivocada
Quien trabaja con etiquetas Zebra conoce ese momento: en el código la etiqueta parece correcta y luego sale impresa desplazada, girada, cortada - o con un código de barras que no se escanea. La respuesta habitual es una pregunta sobre el tipo de herramienta: un visor online por rapidez y colaboración, una herramienta de escritorio para trabajar offline y en redes restrictivas, un script de desarrollo local para desarrolladores que prefieren estar cerca del código. Se añaden unos cuantos criterios - seguridad, colaboración, rapidez de depuración, restricciones de TI, volumen - y la decisión está tomada.
Es un marco que funciona. Para un visor.
zplCloud responde a la misma pregunta de otra manera. No comparamos «qué ventana me muestra la etiqueta», sino que preguntamos «¿dónde se ejecuta todo el camino desde el evento de datos hasta la etiqueta física?». Y ahí la disyuntiva se convierte en una suma: zplCloud es a la vez un visor en la nube, una herramienta de escritorio y una herramienta local - porque el diseño, el renderizado, el streaming y la impresión están en un solo contenedor que arrancas allí donde estén tus datos y tus impresoras. La pregunta ya no es «¿qué tipo de herramienta?», sino «¿en qué entorno despliego el pipeline?»
El cambio en una tabla
| El reparto habitual | La respuesta de zplCloud |
|---|---|
| Visor online / en la nube | zplCloud.com como SaaS - sin instalación: abre un navegador, renderiza una etiqueta, compártela |
| Visor de escritorio (offline, restrictivo) | el mismo contenedor on-prem - tu centro de datos, tu cortafuegos, control total |
| Herramientas de desarrollo locales (cerca del código) | API + CLI + vista de código - renderiza en tu propia CI, a través de un pipeline git, curl o zplcloud send |
No son tres productos. Una base de código, tres entornos de ejecución. Precisamente por eso la lógica de decisión clásica puede darse la vuelta: en lugar de «¿qué tipo de herramienta encaja con mi restricción?», la pregunta pasa a ser «¿qué restricción tengo - y en qué host se ejecuta el contenedor para cumplirla?».
Primero renderizar, después imprimir - con el motor real
El error más común en los proyectos de etiquetas es dar por hecho que «se renderiza» equivale a «se imprime correctamente». zplCloud cierra esa brecha usando el mismo motor para la vista previa y para la impresión.
- El diseñador renderiza la vista previa PNG/PDF/SVG/ZPL en su propio backend - sin servicio de renderizado externo y sin llamadas en tiempo de ejecución a una CDN externa (para nosotros una regla estricta, tanto por cumplimiento normativo como por disponibilidad).
- Lo que ves en la vista previa es, byte a byte, lo que después llega a la impresora como ZPL (
^XA…^XZ). Un renderizado a 203 dpi es un renderizado a 203 dpi - código de barras, QR, fuente TrueType, todo desde un mismo origen. - El motor está construido como una API apta para lotes:
POST /api/zpl,/api/render/png,/api/render/pdf,/api/export/console. Un diseño más N registros son N etiquetas - sin hacer clic etiqueta por etiqueta. - El rendimiento es un principio de diseño, no una función: el renderizado se ejecuta dentro del proceso del contenedor, escala horizontalmente (más réplicas, más capacidad de renderizado) y puede medirse en cualquier entorno con la imagen perftest incluida (
scripts/perftest.sh, modoszpl/pdf/png/zpl-api) - una prueba de carga antes de la puesta en producción en lugar de esperanza después.
Esa es la respuesta a «volumen y regresión»: quien produce muchas variantes de etiquetas de forma programática (plantillas, campos dinámicos, muchos SKU) no necesita una ventana de visor, necesita una ruta de renderizado repetible - y aquí eso es una llamada a la API, no una captura de pantalla.
Eventos en lugar de un botón: streaming de datos y eventos
Un visor es ante todo un control de calidad antes de imprimir. En la logística real, sin embargo, imprimir suele ser la consecuencia de un evento: un evento de pedido, una tarea de picking, un número de serie del MES, una fila del ERP.
zplCloud convierte el evento directamente en el disparador de impresión. Lo alimentan siete buses de mensajes:
- Apache Kafka - suscríbete a un topic; cada mensaje se renderiza con un diseño de etiqueta y se envía a una impresora. Modo cloud (broker en internet, por ejemplo Confluent o MSK) o modo on-prem (broker detrás de tu cortafuegos, consumido por el agente CLI - las credenciales del broker nunca salen de tu red).
- Azure Service Bus, MQTT, AMQP 1.0, RabbitMQ, Amazon SQS y Google Pub/Sub - la misma mecánica para cualquier otro entorno. MQTT es el que cuenta en la planta de producción, donde básculas, escáneres y PLC ya cuelgan del broker.
- Fuentes del data hub - SQL Server, MongoDB, PostgreSQL, MySQL y MariaDB. Búsqueda por pushdown a través del agente CLI: la consulta se ejecuta on-prem y solo el resultado viaja a la plataforma. Las bases de datos en la nube accesibles también pueden conectarse directamente, sin ningún agente.
Y esta es la parte en la que la mayoría de las integraciones de streaming se vuelven vagas, así que seamos precisos:
- El consumidor confirma solo después de una impresión con éxito. ¿Ha fallado la impresión? Kafka deja el offset donde estaba, Service Bus abandona el mensaje y lo manda a la cola de mensajes fallidos (dead-letter) tras tres entregas, MQTT simplemente no confirma y el broker lo vuelve a entregar con QoS 1 o 2. Sin saltos silenciosos, sin bucles de reintentos infinitos.
- Los errores del broker (inaccesible, autenticación rechazada, topic eliminado) no son errores de impresión, así que reciben un backoff exponencial (de 5 s a 60 s) con el estado visible en la interfaz.
- Un keepalive saca a las impresoras Link-OS del modo de espera, para que la primera etiqueta tras una pausa no se retrase por la latencia de activación.
Una etiqueta que no se ha impreso es un hecho físico que alguien tiene que ver. Esa semántica es la que lo garantiza - y esa es la diferencia entre un visor y un pipeline.
En ambas direcciones, bucket incluido
Los archivos de impresión a menudo ya están en un almacenamiento de objetos: etiquetas de transportista, lotes prerrenderizados, archivos históricos que se conservan por normas de retención. Así que el mensaje del bus no tiene por qué llevar el ZPL - puede apuntar a él:
{ "schemaVersion": 1, "printer": "*", "zplRef": { "storage": "archive", "key": "orders/4711.zpl" } }
El archivo se obtiene de S3 o Azure Blob en el momento de imprimir. Y al revés: un destino de salida escribe cada etiqueta impresa de vuelta en un bucket, envía un mensaje a cualquiera de los siete buses y lanza un webhook firmado con HMAC - cada paso se activa por separado, todos después de la impresión, para que un bucket lento nunca frene la línea.
Una interfaz a medida para la planta: Print Views
La otra cara de la misma moneda: no todas las etiquetas vienen de un evento. A menudo hay una persona en la mesa de empaquetado, en expedición, en el almacén - y necesita algo utilizable, no un terminal.
Una Print View es exactamente eso. A partir de un diseño guardado, la plataforma genera un formulario responsive propio, con su propio enlace:
https://print.zplcloud.com/d/{designKey}/{viewSlug}
Lo que eso significa para el flujo de trabajo, y por qué funciona sobre la marcha:
- Mobile-first y PWA: cada vista incluye su propio
manifest.jsony su icono de app. «Añadir a pantalla de inicio» convierte el enlace en un icono de app en Android e iOS que abre directamente el formulario. Una app sin app store, sin instalación, sin drivers. - Un formulario, no un diseñador: campos de texto con validación, desplegables alimentados por una fuente de datos, casillas de verificación. El operador rellena valores, no ZPL. Solo se pueden editar los campos que marcaste como visibles.
- Un botón de escáner junto a cada campo: toca la cámara y escanea un código de barras o QR directamente en el campo. Eso es lo que decide si una Print View sobrevive al contacto con la realidad - teclear un EAN de 13 dígitos en un teléfono en la mesa de empaquetado no lo consigue.
- Vista previa en vivo: una vista previa PDF se vuelve a renderizar mientras escribes, con el mismo motor del servidor que genera el ZPL. Lo que está en pantalla es lo que sale de la impresora.
- Una proyección, no un enlace compartido: los valores se validan en el servidor, los campos bloqueados ni siquiera están en el payload y el diseño en sí nunca llega al navegador. Quien tiene la URL puede imprimir esta etiqueta concreta - no puede acceder a tu cuenta.
La impresión va a una impresora Weblink, a una impresora remota en el agente CLI o a un PDF en el diálogo de impresión local. Y cuando la vista está conectada a una fuente del data hub, una consulta parametrizada extrae la fila de tu ERP y rellena el formulario - la variante DHL incluso compra franqueo real a partir de un ID de pedido e imprime el sello.
Eso cubre todo el espectro: los eventos disparan la impresión automáticamente, las Print Views dan a las personas en movimiento una interfaz segura y mínima - y ambos funcionan con el mismo motor de renderizado en el mismo contenedor.
La verdadera clave: desplegar a través de un pipeline git
Ahora viene la parte que responde a la pregunta «online vs. escritorio vs. local» en un plano completamente distinto: el despliegue.
Un visor se instala. Una plataforma de impresión se despliega - con la misma herramienta con la que tus desarrolladores ya entregan código: git.
La secuencia está construida deliberadamente para que salga bien siempre:
1. Un push a una rama equivale a un despliegue en un entorno. dev va al entorno de pruebas (zplcloud_test), main a producción (zplcloud). Los pipelines de Azure (backend/azure-pipelines-backend.yml, weblink/azure-pipelines-weblink.yml) se disparan con el push a la rama.
2. Docker build desde el repositorio - una sola imagen (frontend Angular más API ASP.NET Core, basada en aspnet:10 azurelinux3, amd64, unos 260 MB).
3. Despliegue blue-green con control de salud: el nuevo contenedor arranca sin puertos del host, se verifica mediante un health check (/api/health) y solo cuando está sano se elimina el antiguo. Si la comprobación falla, rollback, y el contenedor antiguo sigue funcionando intacto. Sin ventana de inactividad, sin cruzar los dedos.
4. Rollback equivale al último estado verde. Como el tag de la imagen es el id del build, volver atrás es un único docker run con el tag anterior - o volver a ejecutar el pipeline sobre el último commit.
Por qué «siempre sale bien»: la migración de la base de datos es aditiva e idempotente (tablas nuevas, columnas nuevas que admiten nulos, scripts IF NOT EXISTS en backend/scripts/*.sql). Por eso la base de datos puede migrarse antes del despliegue del código, y tanto el código antiguo como el nuevo funcionan con el nuevo esquema. El orden es siempre el mismo: copia de seguridad, migración, verificación, regenerar EF, merge, despliegue, smoke test.
Y como todo está en un solo contenedor, el entorno de destino da igual:
- Tu propia nube o centro de datos: ejecuta el contenedor en cualquier host Docker o clúster de Kubernetes.
- On-prem: el agente CLI (
zplcloud proxy --agent, también disponible como contenedor Docker) abre una conexión saliente con la plataforma, al estilo TeamViewer - tus impresoras y brokers se quedan detrás del cortafuegos, sin conexión entrante y sin VPN. - Contenedor Weblink: impresoras Zebra a través de un relay WebSocket (certificados de cliente mTLS), TCP 9100 - desplegable por separado, con su propio pipeline.
Un sistema que despliegas en tu entorno a través de un pipeline git también puede auditarse, versionarse y repetirse a través de un pipeline git. Eso es lo que «escalar» significa realmente aquí: más réplicas para más capacidad de renderizado, más agentes para más sedes, más entornos para más seguridad.
Sin driver, en ningún sitio
El driver es el clásico punto de ruptura: drivers de impresora de Windows, DLL del fabricante, dependencias del sistema operativo. zplCloud esquiva todo eso, porque ZPL es texto.
- La ruta de impresión es un stream TCP 9100 en bruto, un WebSocket o USB - sin driver de impresora y sin software del fabricante en el cliente.
- Independiente de la plataforma: el cliente es un navegador (Angular), el motor es .NET en un contenedor Linux. Windows, macOS, Linux, tablet, Raspberry Pi - da igual, siempre que funcione un navegador o un agente.
- Sin dependencia en tiempo de ejecución de CDN externas: todos los recursos (Tailwind CSS, fuentes, WASM del escáner) están autoalojados. Detrás de un cortafuegos sin internet, el sistema sigue funcionando por completo.
Así se resuelve el escenario «offline / TI restrictiva»: no con un visor de escritorio, sino ejecutando la propia plataforma en local.
Todos los flujos de trabajo, del desarrollador al fabricante
En lugar de «ajustar el tipo de herramienta a tus restricciones», zplCloud ofrece una plataforma para cualquier tamaño - y el arco los abarca todos:
- Desarrolladores: diseñador con vista de código (generación de código C#, ida y vuelta entre diseño y código), API (
/api/zpl,/api/render/*,/api/export/console), CLI (zplcloud send,proxy,firmware). Vista previa del renderizado en la CI, despliegue a través de git - el mismo flujo que cualquier otro servicio. - Una pequeña oficina con sellos: compra franqueo DHL Internetmarke directamente e imprímelo como ZPL en la Zebra. Introduces remitente y destinatario, se carga la cuenta de franqueo y el sello sale de la impresora. Sin máquina franqueadora.
- Impresora de escritorio / puesto único: conecta una impresora USB o de red a través del agente, renderiza e imprime en local - sin la nube, si ese es el requisito.
- Emprendedores y autónomos: un diseño, una Print View, una impresora. Print Views basadas en formularios como PWA móvil, para la etiqueta suelta de cada día en el puesto de trabajo o en ruta.
- Pequeña empresa: cuentas de equipo, diseños compartidos, el data hub (cinco bases de datos más hojas de cálculo), workspaces de clientes para 3PL, permisos por ámbito.
- Logística: etiquetas Amazon FBA desde un CSV (FNSKU, caja, palé), Print Views solo DHL con búsqueda por id de pedido, ejecuciones por lotes.
- Fabricantes: eventos de ERP y MES por Kafka, MQTT o Service Bus directamente a las impresoras de producción - confirmados solo después de la impresión, para que no se pierda ninguna etiqueta.
El hilo conductor: siempre es la misma plataforma. Empezar en pequeño no significa cambiar de categoría de herramienta más adelante; significa activar la siguiente etapa del mismo pipeline.
Tres señales de que funciona
¿Cómo sabes que la ruta de las etiquetas encaja de verdad? Tres señales:
1. Menos impresiones de prueba - porque la vista previa es idéntica al motor de impresión y los errores aparecen antes que la etiqueta física.
2. Desarrollo y operaciones hablan del mismo resultado - porque la etiqueta es un JSON de diseño más ZPL renderizado, un contrato compartido y versionable en lugar de una captura de pantalla.
3. Los cambios de plantilla dejan de sorprender - porque la revisión es repetible (mismo renderizado, mismo motor, mismo entorno) y un despliegue a través del pipeline es un paso trazable y con posibilidad de rollback.
Un visor evita errores. Un pipeline hace que el camino del evento a la etiqueta sea determinista - y esa es, al final, la diferencia que buscaba toda esta categorización.