



zplCloud Blog
Viewer online, tool desktop o script locale? La domanda migliore: dove gira la tua pipeline di etichette?
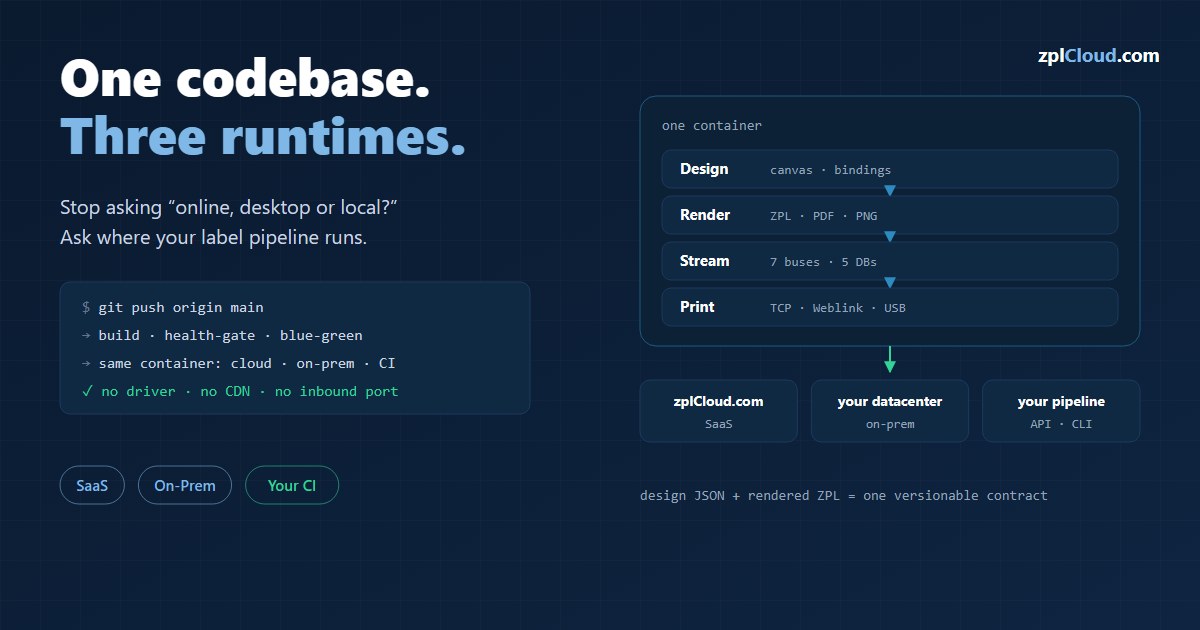
Il dibattito “online vs desktop vs locale” finisce quando design, rendering, streaming e stampa vivono in un unico contenitore - nel cloud, on-prem o nel tuo datacenter, con deploy tramite git push.
Online, desktop o locale - la domanda sbagliata
Chi lavora con le etichette Zebra conosce il momento: nel codice l'etichetta sembra giusta, poi esce stampata spostata, ruotata, tagliata - oppure con un codice a barre che non si lascia scansionare. La risposta abituale è una domanda sul tipo di strumento: un viewer online per velocità e collaborazione, un tool desktop per l'offline e le reti restrittive, uno script di sviluppo locale per gli sviluppatori che restano vicini al codice. Aggiungi qualche criterio - sicurezza, collaborazione, velocità di debug, vincoli IT, volumi - e la decisione è presa.
È uno schema che funziona. Per un viewer.
zplCloud risponde alla stessa domanda in modo diverso. Non confrontiamo “quale finestra mi mostra l'etichetta”, ci chiediamo “dove gira l'intero percorso dall'evento dati all'etichetta fisica?”. E lì l'aut-aut diventa un “e”: zplCloud è insieme un viewer cloud, un tool desktop e uno strumento locale - perché design, rendering, streaming e stampa stanno in un unico contenitore che avvii ovunque si trovino i tuoi dati e le tue stampanti. La domanda non è più “che tipo di strumento?”, ma “in quale ambiente distribuisco la pipeline?”
Il cambio di prospettiva in una tabella
| La suddivisione abituale | La risposta di zplCloud |
|---|---|
| Viewer online / cloud | zplCloud.com come SaaS - nessuna installazione, apri un browser, renderizza un'etichetta, condividila |
| Viewer desktop (offline, ambienti restrittivi) | lo stesso contenitore on-prem - il tuo datacenter, il tuo firewall, pieno controllo |
| Strumenti di sviluppo locali (vicini al codice) | API + CLI + vista codice - renderizza nella tua CI, tramite una pipeline git, curl o zplcloud send |
Non tre prodotti. Un'unica codebase, tre runtime. Ed è proprio per questo che la classica logica decisionale si può capovolgere: invece di “quale tipo di strumento si adatta al mio vincolo?” diventa “quale vincolo ho - e su quale host gira il contenitore per rispettarlo?”.
Prima il rendering, poi la stampa - con il motore reale
L'errore più comune nei progetti di etichette è considerare “si renderizza” equivalente a “si stampa correttamente”. zplCloud colma questo divario usando lo stesso motore per anteprima e stampa.
- Il designer renderizza l'anteprima PNG/PDF/SVG/ZPL nel proprio backend - nessun servizio di rendering esterno, nessuna chiamata a runtime verso una CDN esterna (per noi una regola ferrea, per la compliance come per la disponibilità).
- Ciò che vedi nell'anteprima è, byte per byte, ciò che poi va alla stampante come ZPL (
^XA…^XZ). Un render a 203 dpi è un render a 203 dpi - codice a barre, QR, font TrueType, tutto da un'unica fonte. - Il motore è costruito come API adatta ai batch:
POST /api/zpl,/api/render/png,/api/render/pdf,/api/export/console. Un design più N record fa N etichette - nessun clic per etichetta. - Le prestazioni sono un principio di progettazione, non una funzione: il rendering gira all'interno del processo del contenitore, scala orizzontalmente (più repliche, più throughput di rendering) e può essere misurato su qualsiasi stage con l'immagine perftest inclusa (
scripts/perftest.sh, modalitàzpl/pdf/png/zpl-api) - un test di carico prima del go-live invece della speranza dopo.
Questa è la risposta a “volumi e regressioni”: chi produce molte varianti di etichette in modo programmatico (modelli, campi dinamici, molti SKU) non ha bisogno di una finestra di viewer, ma di un percorso di rendering ripetibile - e qui è una chiamata API, non uno screenshot.
Eventi invece di un pulsante: streaming di dati ed eventi
Un viewer è prima di tutto un controllo qualità prima della stampa. Nella logistica reale, però, la stampa è di solito la conseguenza di un evento: un evento d'ordine, un compito di picking, un numero di serie dal MES, una riga dall'ERP.
zplCloud trasforma l'evento direttamente nel trigger di stampa. Lo alimentano sette bus di messaggi:
- Apache Kafka - iscriviti a un topic; ogni messaggio viene renderizzato con un design di etichetta e inviato a una stampante. Modalità cloud (broker su internet, per esempio Confluent o MSK) o modalità on-prem (broker dietro il tuo firewall, consumato dall'agente CLI - le credenziali del broker non lasciano mai la tua rete).
- Azure Service Bus, MQTT, AMQP 1.0, RabbitMQ, Amazon SQS e Google Pub/Sub - la stessa meccanica per ogni altro ambiente. MQTT è quello che conta in un reparto produttivo, dove bilance, scanner e PLC sono già collegati al broker.
- Sorgenti del data hub - SQL Server, MongoDB, PostgreSQL, MySQL e MariaDB. Ricerca con pushdown tramite l'agente CLI: la query gira on-prem, solo il risultato viaggia verso la piattaforma. Anche i database cloud raggiungibili si possono collegare direttamente, senza alcun agente.
Ed ecco la parte in cui la maggior parte delle integrazioni di streaming diventa vaga, quindi siamo precisi:
- Il consumatore conferma solo dopo una stampa riuscita. Stampa fallita? Kafka lascia l'offset dov'era, Service Bus abbandona il messaggio e lo sposta nella dead-letter dopo tre consegne, MQTT semplicemente non conferma e il broker riconsegna con QoS 1 o 2. Nessun salto silenzioso, nessun loop di retry infinito.
- Gli errori del broker (irraggiungibile, autenticazione rifiutata, topic sparito) non sono errori di stampa, quindi ricevono un backoff esponenziale (da 5 s a 60 s) con lo stato visibile nella UI.
- Un keepalive risveglia le stampanti Link-OS dallo standby, così la prima etichetta dopo una pausa non viene rallentata dalla latenza di risveglio.
Un'etichetta non stampata è un fatto fisico che qualcuno deve vedere. È questa semantica a garantirlo - ed è questa la differenza tra un viewer e una pipeline.
In entrambe le direzioni, bucket compreso
I file di stampa spesso si trovano già in uno storage a oggetti: etichette dei corrieri, batch pre-renderizzati, archivi conservati per obblighi di conservazione. Quindi il messaggio sul bus non deve affatto trasportare lo ZPL - può semplicemente puntarvi:
{ "schemaVersion": 1, "printer": "*", "zplRef": { "storage": "archive", "key": "orders/4711.zpl" } }
Il file viene recuperato da S3 o Azure Blob al momento della stampa. E nella direzione opposta: una destinazione di uscita riscrive ogni etichetta stampata in un bucket, invia un messaggio a uno qualsiasi dei sette bus e attiva un webhook firmato HMAC - ogni passo attivabile separatamente, tutti dopo la stampa, così un bucket lento non ferma mai la linea.
Un'interfaccia su misura per il reparto: le Print View
L'altra faccia della stessa medaglia: non ogni etichetta nasce da un evento. Spesso c'è una persona al banco di imballaggio, in spedizione, in magazzino - e ha bisogno di qualcosa di utilizzabile, non di un terminale.
Una Print View è esattamente questo. Da un design salvato la piattaforma genera un modulo responsive dedicato, con un proprio link:
https://print.zplcloud.com/d/{designKey}/{viewSlug}
Cosa significa per il flusso di lavoro, e perché funziona anche in mobilità:
- Mobile-first e PWA: ogni vista fornisce il proprio
manifest.jsone la propria icona app. “Aggiungi a schermata Home” trasforma il link in un'icona app su Android e iOS che apre direttamente il modulo. Un'app senza app store, senza installazione, senza driver. - Un modulo, non un designer: campi di testo con validazione, menu a tendina da una sorgente dati, caselle di spunta. L'operatore compila valori, non ZPL. Solo i campi che hai marcato come visibili sono modificabili.
- Un pulsante scanner accanto a ogni campo: tocca la fotocamera, scansiona un codice a barre o QR direttamente nel campo. È questo che decide se una Print View sopravvive al contatto con la realtà - digitare un EAN di 13 cifre su un telefono al banco di imballaggio non ci riesce.
- Anteprima live: un'anteprima PDF si ri-renderizza mentre digiti, con lo stesso motore lato server che produce lo ZPL. Ciò che è sullo schermo è ciò che esce dalla stampante.
- Una proiezione, non un link di condivisione: i valori vengono validati lato server, i campi bloccati non sono nemmeno nel payload e il design stesso non raggiunge mai il browser. Chi ha l'URL può stampare questa sola etichetta - non può accedere al tuo account.
La stampa va a una stampante Weblink, a una stampante remota sull'agente CLI o a un PDF nella finestra di stampa locale. E quando la vista è collegata a una sorgente del data hub, una query parametrizzata estrae la riga dal tuo ERP e precompila il modulo - la variante DHL compra perfino affrancatura reale in base a un ID ordine e stampa il francobollo.
Così è coperto l'intero spettro: gli eventi attivano la stampa automaticamente, le Print View danno alle persone in movimento un'interfaccia sicura e minimale - ed entrambi girano sullo stesso motore di rendering nello stesso contenitore.
Il vero punto: il deploy tramite una pipeline git
Veniamo ora alla parte che risponde alla domanda “online vs desktop vs locale” su un piano completamente diverso: il deployment.
Un viewer lo installi. Una piattaforma di stampa la distribuisci - con lo stesso strumento con cui i tuoi sviluppatori già rilasciano il codice: git.
La sequenza è costruita deliberatamente per riuscire ogni volta:
1. Push su un branch equivale a deploy su uno stage. dev va allo stage di test (zplcloud_test), main in produzione (zplcloud). Le pipeline Azure (backend/azure-pipelines-backend.yml, weblink/azure-pipelines-weblink.yml) si attivano al push sul branch.
2. Build Docker dal repository - un'unica immagine (frontend Angular più API ASP.NET Core, basata su aspnet:10 azurelinux3, amd64, circa 260 MB).
3. Deploy blue-green con health gate: il nuovo contenitore si avvia senza porte host, viene verificato tramite un health check (/api/health) e solo quando è sano il vecchio viene rimosso. Se il controllo fallisce, rollback, e il vecchio contenitore continua a girare intatto. Nessuna finestra di downtime, niente dita incrociate.
4. Rollback equivale all'ultimo stato verde. Poiché il tag dell'immagine è l'id della build, tornare indietro è un singolo docker run con il tag precedente - oppure una nuova esecuzione della pipeline sull'ultimo commit.
Perché “riesce sempre”: la migrazione del database è additiva e idempotente (nuove tabelle, nuove colonne nullable, script IF NOT EXISTS in backend/scripts/*.sql). Il database può quindi essere migrato prima del deploy del codice, e sia il codice vecchio sia quello nuovo girano sul nuovo schema. L'ordine è sempre lo stesso: backup, migrazione, verifica, rigenerazione EF, merge, deploy, smoke test.
E poiché tutto sta in un unico contenitore, l'ambiente di destinazione non conta:
- Il tuo cloud o datacenter: esegui il contenitore su qualsiasi host Docker o cluster Kubernetes.
- On-prem: l'agente CLI (
zplcloud proxy --agent, a sua volta disponibile come contenitore Docker) apre una connessione in uscita verso la piattaforma, in stile TeamViewer - le tue stampanti e i tuoi broker restano dietro il firewall, nessuna connessione in ingresso e nessuna VPN necessarie. - Contenitore Weblink: stampanti Zebra tramite un relay WebSocket (certificati client mTLS), TCP 9100 - distribuibile separatamente, con una propria pipeline.
Un sistema che distribuisci nel tuo ambiente tramite una pipeline git può anche essere verificato, versionato e ripetuto tramite una pipeline git. Ecco cosa significa davvero “scalare” qui: più repliche per più throughput di rendering, più agenti per più sedi, più stage per più sicurezza.
Nessun driver, da nessuna parte
Il driver è il classico punto di rottura: driver di stampa Windows, DLL dei produttori, dipendenze dal sistema operativo. zplCloud aggira tutto questo, perché lo ZPL è testo.
- Il percorso di stampa è uno stream TCP 9100 grezzo, un WebSocket o USB - nessun driver di stampa, nessun software del produttore sul client.
- Indipendente dalla piattaforma: il client è un browser (Angular), il motore è .NET in un contenitore Linux. Windows, macOS, Linux, tablet, Raspberry Pi - non importa, purché giri un browser o un agente.
- Nessuna dipendenza a runtime da CDN esterne: ogni risorsa (Tailwind CSS, font, WASM dello scanner) è ospitata in proprio. Dietro un firewall senza internet, il sistema continua a funzionare completamente.
Questo risolve lo scenario “offline / IT restrittivo” non con un viewer desktop, ma eseguendo in locale la piattaforma stessa.
Ogni flusso di lavoro coperto, dallo sviluppatore al produttore
Invece di “scegli il tipo di strumento in base ai tuoi vincoli”, zplCloud offre una piattaforma per ogni dimensione - e l'arco le abbraccia tutte:
- Sviluppatori: designer con vista codice (generazione di codice C#, round trip dal design al codice), API (
/api/zpl,/api/render/*,/api/export/console), CLI (zplcloud send,proxy,firmware). Anteprima di rendering nella CI, deploy tramite git - lo stesso flusso di qualsiasi altro servizio. - Un piccolo ufficio con francobolli: acquista l'affrancatura DHL Internetmarke direttamente e stampala come ZPL sulla Zebra. Inserisci mittente e destinatario, il conto di affrancatura viene addebitato, il francobollo esce dalla stampante. Nessuna affrancatrice necessaria.
- Stampante desktop / postazione singola: collega una stampante USB o di rete tramite l'agente, renderizza e stampa in locale - senza cloud, se questo è il requisito.
- Imprenditori e lavoratori autonomi: un design, una Print View, una stampante. Print View basate su moduli come PWA mobile, per la singola etichetta quotidiana al banco o in viaggio.
- Piccole imprese: account di team, design condivisi, il data hub (cinque database più fogli di calcolo), workspace clienti per 3PL, permessi per ambito.
- Logistica: etichette Amazon FBA da un CSV (FNSKU, cartone, pallet), Print View solo DHL con ricerca per id ordine, esecuzioni batch.
- Produttori: eventi ERP e MES tramite Kafka, MQTT o Service Bus direttamente sulle stampanti di produzione - confermati solo dopo la stampa, così nessuna etichetta va persa.
Il filo conduttore: è sempre la stessa piattaforma. Partire in piccolo non significa cambiare categoria di strumento più avanti; significa attivare lo stage successivo della stessa pipeline.
Tre segnali che funziona
Come capisci se il percorso delle etichette è davvero quello giusto? Tre segnali:
1. Meno stampe di prova - perché l'anteprima è identica al motore di stampa e gli errori emergono prima dell'etichetta fisica.
2. Dev e ops parlano dello stesso output - perché l'etichetta è un JSON di design più ZPL renderizzato, un contratto condiviso e versionabile anziché uno screenshot.
3. Le modifiche ai modelli smettono di sorprendere - perché la revisione è ripetibile (stesso render, stesso motore, stesso stage) e un deploy tramite la pipeline è un passo tracciabile e annullabile con un rollback.
Un viewer previene gli errori. Una pipeline rende deterministico il percorso dall'evento all'etichetta - ed è questa, alla fine, la differenza a cui tutta questa classificazione cercava di arrivare.