



zplCloud Blog
SQL Server comme source de données : la boucle d'export, éliminée
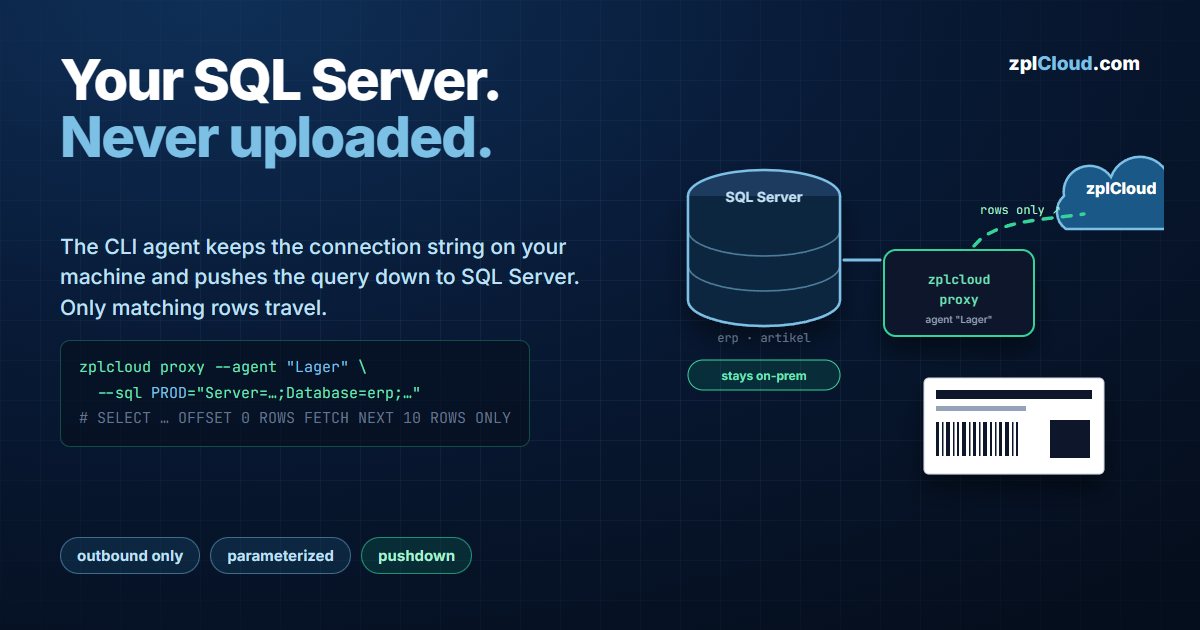
La chaîne de connexion ne quitte jamais votre machine. Filtres, tri et pagination s'exécutent en T-SQL paramétré sur votre serveur.
La boucle d'export, et pourquoi elle casse
Les données d'étiquettes vivent dans un ERP, un WMS ou une base Azure SQL. Le flux habituel est d'exporter en CSV, corriger les noms de colonnes, téléverser, imprimer - et de répéter demain, parce que le CSV est déjà obsolète.
Le data hub zplCloud supprime l'export. Un agent CLI dans votre réseau détient la chaîne de connexion SQL Server, la plateforme lui envoie une description de requête, et seules les lignes de résultat reviennent. La base n'est jamais exposée à internet et les identifiants ne sont jamais stockés dans le cloud.
Ce post est la mécanique exacte : ce qui s'exécute où, quel SQL est généré, et quelles sont les limites dures.
Architecture en un paragraphe
zplcloud proxy ouvre une connexion TLS sortante vers api.zplcloud.com (SignalR). Pas de port entrant, pas de règle NAT, pas de VPN. Quand vous ouvrez une source de données dans la plateforme, le backend envoie à l'agent un objet de requête - requête de base, filtre, tri, offset, limite - et l'agent le transforme en T-SQL, l'exécute contre votre SQL Server avec votre utilisateur de base de données, et renvoie les lignes. La chaîne de connexion n'existe que dans la mémoire du processus de l'agent et sa configuration locale.
Étape 1 - démarrez l'agent avec un ou plusieurs serveurs
# Plusieurs drapeaux --sql sont autorisés ; le NOM est ce que vous choisissez dans la plateforme.
zplcloud proxy --agent "Lager" \
  --sql PROD="Server=127.0.0.1;Database=erp;User Id=zplcloud;Password=…;Encrypt=True;TrustServerCertificate=True" \
  --sql WAREHOUSE="Server=sql-wh.internal.lan,1433;Database=logistik;User Id=zplcloud;Password=…;Encrypt=True;TrustServerCertificate=True"
Équivalent sans mettre les secrets dans la ligne de commande (ils finiraient dans l'historique du shell) :
# Windows PowerShell - une variable par serveur, nom au milieu
$env:ZPLCLOUD_SQL_PROD_CONNECTION = "Server=127.0.0.1;Database=erp;User Id=zplcloud;Password=…;Encrypt=True;TrustServerCertificate=True"
zplcloud proxy --agent "Lager"
La bannière de démarrage liste ce qui a été trouvé : SQL servers: PROD, WAREHOUSE. L'authentification auprès de la plateforme utilise --api-key <key> ou ZPLCLOUD_API_KEY.
Rendez-le persistant pour un fonctionnement sans surveillance :
- Windows :
setx ZPLCLOUD_SQL_PROD_CONNECTION "…", ouzplcloud proxy --agent "Lager" --service-install --api-key sk_zplcloud_… - Linux/Raspberry Pi : même drapeau
--service-install; il écrit une unité systemdzplcloud-agent.serviceavecRestart=always - Fichier au lieu de l'env :
sqlservers.jsonà côté du binaire ou dans~/.zplcloud/, forme{ "sqlServers": { "PROD": "Server=…" } } - Docker :
ZPLCLOUD_SQL_PROD_CONNECTIONdansdocker-compose.agent.yml
Notes sur les chaînes de connexion qui coûtent une heure aux gens
Encrypt=True;TrustServerCertificate=Trueest la paire pragmatique pour un serveur interne avec un certificat auto-signé. RetirezTrustServerCertificateune fois que vous avez un vrai certificat.- Une instance nommée nécessite
Server=hôte\INSTANCE; un port non standard estServer=hôte,1433- virgule, pas deux-points. - Utilisez un login SQL dédié avec
SELECTexactement sur les tables dont les étiquettes ont besoin. L'agent exécute tout en tant que cet utilisateur, donc la base de données est la frontière des permissions - pas la plateforme.
Étape 2 - créez la source de données
Dans Sources de données, l'agent en cours d'exécution apparaît sous Remote SQL Server avec une puce par nom configuré. Cliquer sur une puce pré-remplit le formulaire.
| Champ | Valeur |
|---|---|
| Nom | Lager-Artikel |
| Type | SQL Server |
| Serveur | PROD (le nom de --sql PROD=…) |
| Requête | SELECT ean, name, price FROM artikel |
Tester exécute SELECT 1 et renvoie serveur · base de données. Champs lit les métadonnées de colonnes via SELECT TOP 1 * avec CommandBehavior.SchemaOnly - il récupère le schéma sans tirer les données. Si une requête très imbriquée ne renvoie pas de schéma, l'agent réessaie une fois avec SingleRow.
Étape 3 - ce que l'agent exécute réellement
Votre requête de base est enveloppée comme sous-requête. Le filtre, le tri et la pagination sont ajoutés par l'agent :
SELECT * FROM ( SELECT ean, name, price FROM artikel ) AS ds
WHERE ean LIKE @p0
ORDER BY name
OFFSET 0 ROWS FETCH NEXT 10 ROWS ONLY
Trois choses méritent d'être lues deux fois :
1. Les valeurs sont des paramètres, jamais de concaténation de chaînes. Le constructeur de filtres émet @p0, @p1, … et lie les valeurs via SqlCommand.Parameters. Il n'y a aucun endroit où une valeur saisie par l'utilisateur devient du texte SQL.
2. La pagination est native. limit 10 devient FETCH NEXT 10 ROWS ONLY ; SQL Server fait le travail et renvoie dix lignes sur le fil, pas un million.
3. Le comptage des lignes est une requête séparée. Quand vous demandez le total, l'agent exécute SELECT COUNT(*) FROM (<base>) AS ds avec le même WHERE et les mêmes paramètres.
Les limites dures (du code source de l'agent)
| Limite | Valeur | Où elle s'applique |
|---|---|---|
| Lignes par requête | 1000 (RowCap) | limit est plafonné à 1…1000 ; défaut quand non défini : 100 |
| Délai de commande | 15 s | test, describe, query et count |
| Type d'instruction | SELECT uniquement | la requête de base est validée ; les instructions multiples sont rejetées |
| Colonnes de tri/filtre | identifiants validés | pas transmises comme SQL libre |
Si vous avez besoin de plus de 1000 lignes dans une vue - impression par lots, un catalogue complet - la plateforme page à travers le jeu de résultats avec un OFFSET croissant. Chaque page est sa propre requête de 1000 lignes contre votre serveur, donc la mémoire reste plate quel que soit le total.
Un délai de 15 secondes est délibéré. Si votre requête de base ne peut pas répondre en 15 secondes, elle appartient à une vue indexée ou à une table avec le bon index, pas à une source de données d'étiquettes.
Étape 4 - utilisez-le dans le designer et dans les Print Views
- Designer → onglet Données de test → Source de données : choisissez la source de données et appuyez sur Charger. Les bindings de champs se rendent avec de vraies lignes au lieu de texte d'espace réservé, donc vous voyez les longueurs réelles des champs avant que quoi que ce soit n'atteigne une imprimante.
- Print Views → configuration → Source de données (data hub) : l'aperçu de la vue et son impression utilisent la requête en direct. L'opérateur voit des données actuelles ; personne ne re-téléverse un CSV.
Modes d'échec et leur signification
| Symptôme | Cause |
|---|---|
| L'agent démarre mais aucune puce n'apparaît | nom --sql manquant, ou l'agent s'est authentifié avec une clé d'un autre workspace |
Tester échoue instantanément | chaîne de connexion incorrecte (instance, port, identifiants) - l'erreur est transmise depuis SQL Server |
Tester se bloque, puis échoue | délai de 15 s : serveur injoignable depuis la machine de l'agent, ou un pare-feu abandonne le paquet en silence |
Champs ne renvoie rien | la requête de base est trop imbriquée pour SchemaOnly ; l'agent retombe sur SingleRow, qui a besoin d'au moins une ligne existante |
| La requête fonctionne, la Print View est vide | la vue est liée à une autre source de données, ou le filtre exclut toutes les lignes |
Plan
Le data hub (sources de données SQL Server et MongoDB via l'agent CLI) fait partie du plan Pro. Détails sur la page de prix.